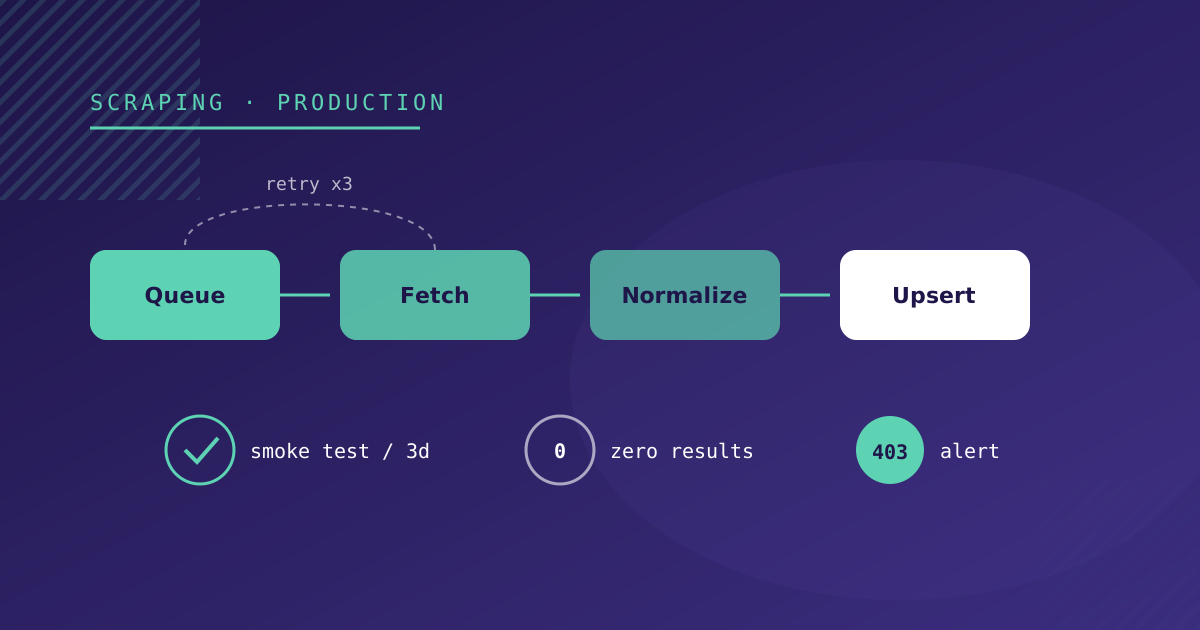
Um scraper parte-se por motivos que não estão no seu código: o site muda de design, move um URL, ativa uma firewall ou deixa de publicar o feed. Nenhuma destas mudanças chega com aviso e, se ninguém a detetar, o primeiro sintoma é um utilizador a perguntar porque faltam dados.
Mantemos uma plataforma de agregação com mais de 35 fontes públicas. Isto é o que temos montado para darmos pelo problema antes do utilizador, ordenado pelo que mais nos ajudou.
Três níveis de teste, cada um com o seu trabalho
| Nível | Contra quê | Quando corre | O que deteta |
|---|---|---|---|
| Unitário | Uma captura guardada da resposta real | Em cada PR | Que o nosso parser continua a entender o formato |
| Integração | Base de dados de teste | Em cada PR | Que normalizar e guardar não duplica nem perde campos |
| Smoke | O site real | A cada três dias em CI | Que a fonte continua lá e com a estrutura que esperamos |
A distinção conta porque os dois primeiros nunca deveriam falhar por culpa de terceiros. Se o teste unitário chamasse o site real, um redesign da fonte bloquearia qualquer PR, mesmo que não tivesse nada a ver com scraping.
O teste unitário usa uma resposta real guardada
Quando acrescentamos uma fonte, guardamos uma resposta real como fixture: o JSON da API, o XML do feed ou o HTML da listagem. O teste processa esse ficheiro e verifica campo a campo o que sai. Cada formato estranho que aparece depois (um preço vazio, uma data sem ano, uma categoria com outro nome) é acrescentado ao fixture como caso novo.
O smoke test chama o site a sério
Há um por fonte e é curto. Para uma fonte de HTML:
describe('Fonte X — smoke', () => {
  let html: string;

  beforeAll(async () => {
    const res = await axios.get(URL, { timeout: 30_000, headers: DEFAULT_HEADERS });
    html = res.data;
  });

  it('devolve HTML', () => expect(html).toContain('<html'));

  it('tem cartões na listagem', () => {
    const $ = cheerio.load(html);
    expect($('.views-row').length).toBeGreaterThanOrEqual(1);
  });

  it('o primeiro cartão tem título', () => {
    const $ = cheerio.load(html);
    expect($('.views-row').first().find('h2 a, h3 a').text().trim()).not.toBe('');
  });
});
Não verifica quantos elementos há, porque isso muda todos os dias. Verifica que a estrutura de que o scraper depende continua a existir. E no cabeçalho de cada ficheiro deixamos escrito o que ver se falhar: o URL, o CMS do site e onde estão os seletores na configuração.
Correm no GitHub Actions a cada três dias (cron: '0 8 */3 * *') e também podem ser lançados à mão. Três dias é o nosso compromisso entre não martelar os sites de origem e não demorar uma semana a dar por um redesign.
Cada execução deixa rasto
Cada fonte é um trabalho numa fila BullMQ sobre Redis. Um planeador verifica de hora a hora que fontes têm de ser executadas consoante a sua frequência e coloca-as na fila. Se uma execução falhar, é repetida três vezes com espera exponencial a começar em 30 segundos. Se a lançarmos à mão a partir do painel, uma só tentativa: quando alguém a lança à mão está a olhar e quer ver o erro logo.
Cada execução guarda um registo:
- estado (
RUNNING,SUCCESS,FAILED) - elementos encontrados e elementos novos
- mensagem de erro, se houver
- início e fim
Com isso responde-se depressa a «desde quando é que não entra nada desta fonte?», que é a primeira pergunta quando algo falha.
A falha que não lança nenhum erro: zero resultados
Este foi o caso que mais nos custou ver. Um site muda a classe CSS dos seus cartões, o seletor não encontra nada e o scraper termina com sucesso: zero elementos, nenhum erro, estado SUCCESS.
Por isso o relatório diário não se limita a separar sucessos de falhas. Agrupa as fontes em quatro listas:
- Com sucesso, com elementos encontrados e novos.
- Falhadas, com o erro.
- Com zero resultados, mesmo que tenham terminado bem.
- Não executadas no período, o que costuma indicar que a fonte está desativada ou que o planeador não a colocou na fila.
A terceira lista é a que mais problemas nos revelou. Uma fonte que traz sempre entre 10 e 20 elementos e um dia traz zero está partida, mesmo que o estado diga o contrário.
Um alerta que diz o que verificar
Quando uma execução falha de verdade, chega um email à equipa. Fomos ampliando-o sempre que um alerta nos obrigava a abrir cinco separadores para o perceber. Hoje inclui:
- fonte, estratégia e configuração
- código HTTP e os primeiros caracteres da resposta
- stack trace do erro
- as últimas cinco execuções dessa fonte
- uma sugestão consoante o tipo de erro
As sugestões são regras simples sobre o código HTTP, a mensagem de erro e a estratégia da fonte:
| Sinal | Sugestão |
|---|---|
| 403 | O site bloqueia pedidos automáticos: rever o User-Agent, passar para navegador headless ou para uma saída com desbloqueio |
| 404 | O URL mudou |
| 429 | Limitação de pedidos: baixar a frequência ou acrescentar esperas |
| 500, 502, 503 | O site de origem está em baixo; verificar à mão antes de investigar mais |
| timeout, ECONNABORTED | Site lento ou inacessível; rever o timeout |
| ENOTFOUND, ECONNREFUSED | Domínio alterado ou site em baixo |
| Erro de leitura em HTML | A estrutura mudou: rever os seletores |
| Erro de JSON em API | O formato mudou: rever o mapeamento de campos |
Com essa tabela, a maioria dos alertas resolve-se sem abrir o código. Uma pessoa que não escreveu o scraper sabe por onde começar.
Um documento por fonte
Cada fonte tem um ficheiro Markdown com a sua configuração, um exemplo do formato de dados, os problemas conhecidos e o que está pendente. Exigimo-lo tal como o teste: sem documento, a fonte não é adicionada.
O documento existe porque cada site tem as suas particularidades, e na segunda vez que alguém as investiga já se perde tempo. Exemplos reais da nossa tabela de problemas conhecidos:
- o preço chega como string vazia e tem de ser tratado como «sem preço», não como 0
- o campo «gratuito» vem como número
0ou1 - o URL da API redireciona para outro domínio e é preciso seguir o redirecionamento
- o site responde 403 embora o seu robots.txt permita o acesso
- o feed mistura tipos de conteúdo e é preciso filtrá-los pelo prefixo do
guid
O que se parte e não é a fonte
Nem todas as falhas vêm de fora. Uma das nossas fontes com navegador headless foi abaixo porque um ambiente foi publicado sem a variável que indica onde está o binário do Chromium. O erro dizia Executable doesn't exist at /root/.cache/ms-playwright/... e o smoke test, que usa um cliente HTTP, continuava verde porque o site estava bem.
Desde então tratamo-lo como parte do deploy: a imagem Docker instala o Chromium, fixa o caminho por variável de ambiente e documentamo-lo na página da estratégia. Se o ambiente não puder levar um navegador, a alternativa é ligar-se a um remoto; é o que fazemos com o Scraping Browser da Bright Data nas fontes que além disso bloqueiam por IP.
Checklist de operação
- Teste unitário com uma resposta real guardada, em cada PR.
- Smoke test contra o site real, programado e separado dos PR.
- Fila com novas tentativas e espera exponencial; uma só tentativa nas execuções manuais.
- Registo por execução com encontrados, novos e erro.
- Relatório diário que separe as fontes com zero resultados.
- Alerta com código HTTP, resposta, histórico e sugestão.
- Um documento por fonte com os seus problemas conhecidos.
Antes disto, explicámos como escolhemos a estratégia de cada fonte. E se tem scrapers que se partem sem que ninguém dê por isso, no nosso serviço de web scraping começamos por montar esta vigilância.