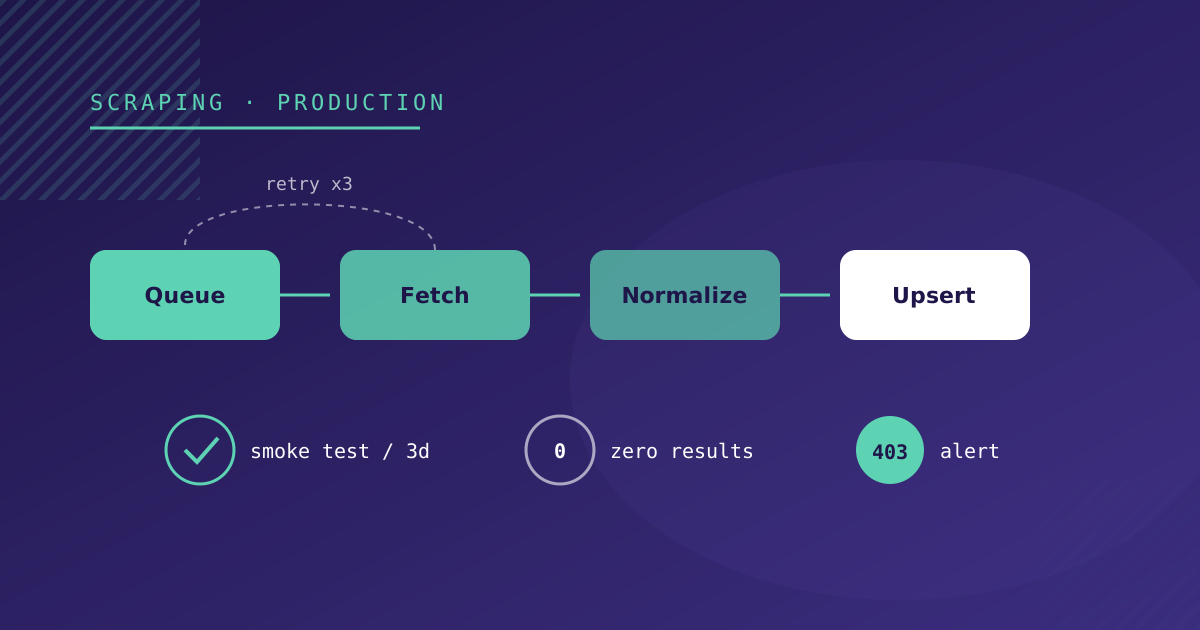
Ein Scraper geht aus Gründen kaputt, die nicht in Ihrem Code liegen: Die Website ändert ihr Design, verschiebt eine URL, schaltet eine Firewall ein oder hört auf, den Feed zu veröffentlichen. Keine dieser Änderungen wird angekündigt, und wenn niemand sie bemerkt, ist das erste Symptom ein Nutzer, der fragt, warum Daten fehlen.
Wir betreiben eine Aggregationsplattform mit mehr als 35 öffentlichen Quellen. Das haben wir aufgebaut, um es vor dem Nutzer zu erfahren, sortiert nach dem, was uns am meisten geholfen hat.
Drei Testebenen, jede mit ihrer Aufgabe
| Ebene | Wogegen | Wann sie läuft | Was sie erkennt |
|---|---|---|---|
| Unit | Ein gespeicherter Snapshot der echten Antwort | Bei jedem PR | Dass unser Parser das Format weiterhin versteht |
| Integration | Testdatenbank | Bei jedem PR | Dass Normalisieren und Speichern weder dupliziert noch Felder verliert |
| Smoke | Die echte Website | Alle drei Tage in der CI | Dass die Quelle noch da ist und die erwartete Struktur hat |
Die Trennung ist wichtig, weil die ersten beiden nie wegen eines Dritten fehlschlagen sollten. Würde der Unit-Test die echte Website aufrufen, würde ein Redesign der Quelle jeden PR blockieren, auch wenn er nichts mit Scraping zu tun hat.
Der Unit-Test nutzt eine gespeicherte echte Antwort
Wenn wir eine Quelle hinzufügen, speichern wir eine echte Antwort als Fixture: das JSON der API, das XML des Feeds oder das HTML der Liste. Der Test verarbeitet diese Datei und prüft Feld für Feld, was herauskommt. Jedes ungewöhnliche Format, das später auftaucht (ein leerer Preis, ein Datum ohne Jahr, eine Kategorie unter anderem Namen), kommt als neuer Fall in die Fixture.
Der Smoke-Test ruft die echte Website auf
Es gibt einen pro Quelle, und er ist kurz. Für eine HTML-Quelle:
describe('Quelle X — smoke', () => {
  let html: string;

  beforeAll(async () => {
    const res = await axios.get(URL, { timeout: 30_000, headers: DEFAULT_HEADERS });
    html = res.data;
  });

  it('liefert HTML', () => expect(html).toContain('<html'));

  it('hat Karten in der Liste', () => {
    const $ = cheerio.load(html);
    expect($('.views-row').length).toBeGreaterThanOrEqual(1);
  });

  it('die erste Karte hat einen Titel', () => {
    const $ = cheerio.load(html);
    expect($('.views-row').first().find('h2 a, h3 a').text().trim()).not.toBe('');
  });
});
Er prüft nicht, wie viele Einträge es gibt, weil sich das jeden Tag ändert. Er prüft, ob die Struktur, von der der Scraper abhängt, noch existiert. Und im Kopf jeder Datei steht, was bei einem Fehlschlag zu prüfen ist: die URL, das CMS der Website und wo die Selektoren in der Konfiguration liegen.
Die Tests laufen alle drei Tage in GitHub Actions (cron: '0 8 */3 * *') und lassen sich auch von Hand starten. Drei Tage sind unser Kompromiss zwischen zwei Zielen: die Ursprungs-Websites nicht zu überlasten und nicht eine Woche zu brauchen, um ein Redesign zu bemerken.
Jeder Lauf hinterlässt Spuren
Jede Quelle ist ein Job in einer BullMQ-Queue auf Redis. Ein Scheduler prüft jede Stunde, welche Quellen laut ihrer Frequenz dran sind, und reiht sie ein. Schlägt ein Lauf fehl, wird er dreimal wiederholt, mit exponentiellem Backoff ab 30 Sekunden. Starten wir ihn von Hand aus dem Dashboard, gibt es nur einen Versuch: Wer ihn von Hand startet, schaut gerade zu und will den Fehler sofort sehen.
Jeder Lauf speichert einen Datensatz:
- Status (
RUNNING,SUCCESS,FAILED) - gefundene und neue Einträge
- Fehlermeldung, falls vorhanden
- Start und Ende
Damit lässt sich schnell die Frage beantworten, die bei einem Fehler als Erstes kommt: Seit wann kommt von dieser Quelle nichts mehr?
Der Fehler, der keinen Fehler wirft: null Treffer
Diesen Fall haben wir am längsten übersehen. Eine Website ändert die CSS-Klasse ihrer Karten, der Selektor findet nichts, und der Scraper endet erfolgreich: null Einträge, kein Fehler, Status SUCCESS.
Deshalb trennt der tägliche Bericht nicht nur Erfolge von Fehlschlägen. Er sortiert die Quellen in vier Listen:
- Erfolgreich, mit gefundenen und neuen Einträgen.
- Fehlgeschlagen, mit dem Fehler.
- Mit null Treffern, auch wenn sie sauber durchgelaufen sind.
- Nicht gelaufen im Zeitraum, was meist bedeutet, dass die Quelle deaktiviert ist oder der Scheduler sie nicht eingereiht hat.
Die dritte Liste hat uns die meisten Probleme aufgedeckt. Eine Quelle, die immer zwischen 10 und 20 Einträge liefert und eines Tages null, ist kaputt, auch wenn der Status etwas anderes sagt.
Ein Alert, der sagt, was zu prüfen ist
Schlägt ein Lauf tatsächlich fehl, bekommt das Team eine E-Mail. Wir haben sie jedes Mal erweitert, wenn wir für einen Alert fünf Tabs öffnen mussten, um ihn zu verstehen. Heute enthält sie:
- Quelle, Strategie und Konfiguration
- HTTP-Statuscode und die ersten Zeichen der Antwort
- Stacktrace des Fehlers
- die letzten fünf Läufe dieser Quelle
- einen Vorschlag je nach Fehlertyp
Die Vorschläge sind einfache Regeln auf Basis von HTTP-Statuscode, Fehlermeldung und Strategie der Quelle:
| Signal | Vorschlag |
|---|---|
| 403 | Die Website blockiert automatisierte Anfragen: User-Agent prüfen, auf Headless-Browser oder einen Ausgang mit Unblocking umstellen |
| 404 | Die URL hat sich geändert |
| 429 | Rate Limiting: Frequenz senken oder Pausen einbauen |
| 500, 502, 503 | Die Ursprungs-Website ist down; von Hand prüfen, bevor man weiter sucht |
| timeout, ECONNABORTED | Website langsam oder nicht erreichbar; Timeout prüfen |
| ENOTFOUND, ECONNREFUSED | Domain geändert oder Website down |
| Lesefehler im HTML | Die Struktur hat sich geändert: Selektoren prüfen |
| JSON-Fehler in der API | Das Format hat sich geändert: Feld-Mapping prüfen |
Mit dieser Tabelle lassen sich die meisten Alerts lösen, ohne den Code zu öffnen. Auch wer den Scraper nicht geschrieben hat, weiß, wo er anfangen muss.
Ein Dokument pro Quelle
Jede Quelle hat eine Markdown-Datei mit ihrer Konfiguration, einem Beispiel des Datenformats, den bekannten Problemen und den offenen Punkten. Wir verlangen sie genauso wie den Test: Ohne Dokument wird die Quelle nicht angelegt.
Das Dokument gibt es, weil jede Website ihre Eigenheiten hat, und wenn jemand sie zum zweiten Mal untersucht, geht schon Zeit verloren. Echte Beispiele aus unserer Tabelle bekannter Probleme:
- der Preis kommt als leerer String und muss als „kein Preis“ behandelt werden, nicht als 0
- das Feld „kostenlos“ kommt als Zahl
0oder1 - die URL der API leitet auf eine andere Domain weiter, und der Weiterleitung muss gefolgt werden
- die Website antwortet mit 403, obwohl ihre robots.txt den Zugriff erlaubt
- der Feed mischt Inhaltstypen, die über das Präfix der
guidgefiltert werden müssen
Was kaputtgeht und nicht die Quelle ist
Nicht jeder Fehler kommt von außen. Eine unserer Quellen mit Headless-Browser fiel aus, weil eine Umgebung ohne die Variable deployt wurde, die angibt, wo das Chromium-Binary liegt. Die Fehlermeldung lautete Executable doesn't exist at /root/.cache/ms-playwright/..., und der Smoke-Test, der einen HTTP-Client nutzt, blieb grün, weil die Website in Ordnung war.
Seitdem behandeln wir das als Teil des Deployments: Das Docker-Image installiert Chromium, legt den Pfad per Umgebungsvariable fest, und wir dokumentieren das auf der Seite der Strategie. Kann die Umgebung keinen Browser mitbringen, besteht die Alternative darin, sich mit einem Remote-Browser zu verbinden. Das machen wir mit dem Scraping Browser von Bright Data bei den Quellen, die zusätzlich nach IP sperren.
Checkliste für den Betrieb
- Unit-Test mit einer gespeicherten echten Antwort, bei jedem PR.
- Smoke-Test gegen die echte Website, geplant und getrennt von den PRs.
- Queue mit Retries und exponentiellem Backoff; nur ein Versuch bei manuellen Läufen.
- Protokoll pro Lauf mit gefundenen und neuen Einträgen und Fehler.
- Täglicher Bericht, der die Quellen mit null Treffern getrennt ausweist.
- Alert mit HTTP-Statuscode, Antwort, Verlauf und Vorschlag.
- Ein Dokument pro Quelle mit ihren bekannten Problemen.
Davor haben wir erklärt, wie wir die Strategie jeder Quelle wählen. Und wenn Sie Scraper haben, die kaputtgehen, ohne dass es jemand merkt: Bei unserem Web-Scraping-Service bauen wir als Erstes diese Überwachung auf.