Quando nos chega uma lista de sites de onde tirar dados, a tentação é abrir o Playwright e começar a escrever seletores. Das quatro estratégias que usamos, é a mais lenta, a que gasta mais memória e a que mais se parte.
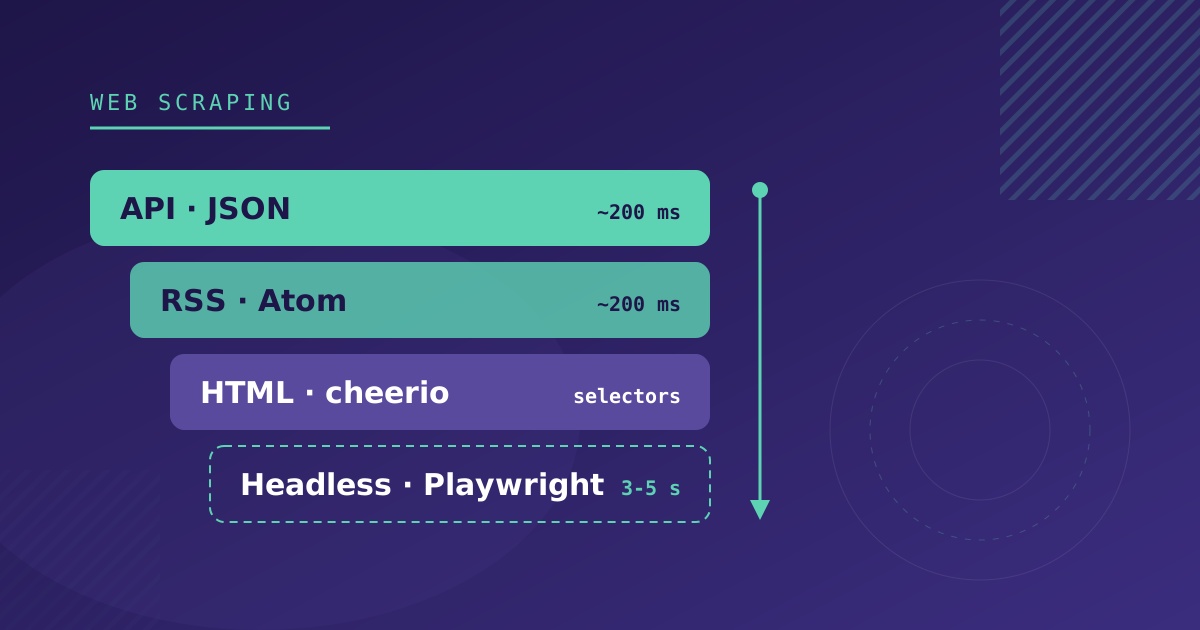
Num projeto de agregação que mantemos, com mais de 35 fontes públicas (portais de dados abertos, sites em WordPress, Drupal, React e alguns feitos à mão), acabámos com quatro estratégias por trás de uma mesma interface e uma regra para escolher entre elas: a primeira da lista que a fonte permita.
As quatro estratégias, da mais estável à mais frágil
| Estratégia | Quando | Custo | O que se parte |
|---|---|---|---|
| API pública ou interna | O site carrega os seus dados a partir de um JSON | ~200 ms por pedido | Alterações de esquema, pouco frequentes |
| RSS / Atom | Há um feed e bastam título, link e resumo | ~200 ms por feed | A data do feed não é a do conteúdo |
| HTML estático | O conteúdo vem no HTML do servidor | Um pedido por listagem, mais as fichas | Os seletores, a cada redesign |
| Navegador headless | JavaScript, scroll infinito, «carregar mais» | 3-5 s por página, 100-200 MB de RAM | Tempos de espera e o binário do navegador |
Descer um degrau custa velocidade e estabilidade. Por isso o inventário de cada fonte começa sempre por cima.
1. Procure a API antes de olhar para o HTML
Muitos mais sites do que parece carregam os seus dados a partir de um JSON. Há três sítios onde procurar, por esta ordem.
Portais de dados abertos. Muitas administrações publicam os seus conjuntos de dados em JSON ou CSV com licença de reutilização. São a melhor fonte possível, embora não a mais limpa. Num dos nossos, o preço chega como string vazia quando não há preço, o campo «gratuito» vem como 0 ou 1 numérico e a morada é um objeto aninhado com chaves com hífen (street-address) que o nosso mapeamento por caminhos com pontos não resolvia à primeira. Nenhum destes detalhes está na documentação do portal: aparecem ao processar a primeira resposta real.
WordPress. Uma parte enorme dos sites pequenos e médios é WordPress, e muitos deixam a REST API aberta. Experimente /wp-json/wp/v2/posts. Se o site usar um plugin de calendário como o The Events Calendar, /wp-json/tribe/events/v1/events devolve os eventos com data de início, data de fim, local e custo já estruturados. Três das nossas fontes, que à primeira vista pediam um scraper de HTML, saem assim.
O separador Network. Abra as DevTools, filtre por Fetch/XHR e recarregue. Se o site for uma SPA, os dados vêm de algum endpoint, e muitas vezes este aceita parâmetros de data e paginação. Uma das nossas fontes, uma bilheteira online, só devolve uma janela de duas semanas, por isso o URL guardado na configuração leva marcadores que se resolvem em cada execução:
https://ejemplo.com/api/sesiones?desde={{today}}&hasta={{today+14}}Antes de usar um endpoint interno convém ler os termos de utilização do site. Um JSON estar acessível não significa que a sua reutilização seja permitida.
2. RSS, rápido mas com uma armadilha na data
Um feed RSS processa-se em milissegundos e quase nunca muda de formato. O problema é o que não traz. O pubDate de cada elemento é a data em que o artigo foi publicado, não a do evento, da oferta ou do produto de que fala. E não há preço, nem local, nem data de fim.
Além disso, os feeds de meios de comunicação misturam conteúdos. Um dos que usamos inclui artigos, fichas de espaços e guias no mesmo canal; o guid leva um prefixo por tipo (Content-Venue-213605, Content-Article-…) e é isso que permite separá-los.
Usamos o RSS como fonte de descoberta: deteta que há algo novo e, se for preciso, visitamos a ficha para completar os dados.
3. HTML estático, com os seletores na configuração
Quando o conteúdo vem no HTML que o servidor devolve, basta um pedido HTTP e o cheerio. A decisão que mais tempo nos poupou aqui foi guardar os seletores na configuração da fonte e não no código:
{
  "listUrl": "https://ejemplo.com/agenda",
  "selectors": {
    "card": ".agenda-item",
    "title": ".agenda-item__title",
    "link": "a",
    "date": ".agenda-item__date",
    "image": "img"
  }
}
Quando o site muda de design, a correção é editar esse JSON. Não é preciso fazer deploy.
Dois casos a prever:
- Classes com hash. Os sites feitos com Gatsby ou Next.js e CSS Modules geram classes como
card-module--title--a1b2c, e o hash muda a cada build do site. O seletor tem de ir por prefixo:[class*="card-module--title"]. - Listagens incompletas. Se o cartão da listagem não trouxer descrição, é preciso visitar a ficha de cada elemento. Fazemo-lo por lotes com concorrência limitada e só para os elementos que ainda não a têm.
4. Navegador headless, quando não há outra saída
O Playwright é necessário em três situações: o conteúdo é desenhado com JavaScript, a página carrega mais resultados ao fazer scroll ou com um botão de «carregar mais», ou o site rejeita qualquer cliente HTTP que não seja um navegador.
O que aprendemos a mantê-lo:
- Espere por um seletor concreto, não por um tempo fixo.
waitForSelector('.agenda-item')é fiável;waitForTimeout(3000)falha no dia em que o site está lento. - O
networkidlepode nunca chegar em sites com analítica ou chat que não param de fazer pedidos. Depois de carregar em «carregar mais» aceitamos o timeout donetworkidlee verificamos se apareceram cartões novos. - Feche o navegador num
finally. Cada instância do Chromium ocupa entre 100 e 200 MB, e um navegador que fica aberto depois de uma exceção acaba por deitar abaixo o worker. - O binário faz parte do deploy. Lançamos o Chromium a partir de um caminho definido por variável de ambiente, e a imagem Docker instala-o. Um ambiente que ficou sem essa variável teve uma fonte em baixo com
browserType.launch: Executable doesn't exist, e o código não tinha nenhuma falha.
Um navegador próprio não resolve todos os bloqueios. Várias das nossas fontes devolvem 403 a qualquer cliente HTTP, uma delas com o robots.txt aberto. Se o bloqueio depender do IP ou da impressão digital do navegador, um Playwright lançado a partir de um servidor de centro de dados também não passa. Para esses casos integramos a Bright Data na fonte concreta, sem mexer nas outras.
O problema que todas partilham: as datas em espanhol
Seja qual for a estratégia, no fim é preciso converter texto em datas. Nas nossas fontes, que estão em espanhol, convivem «Del 10 al 28 de junio», «Martes, 3 de marzo», «jun 25», «25.06» e «25/06/2026».
A armadilha está no Date do JavaScript. No Node:
new Date('25 junio')  // Mon Jun 25 2001
new Date('jun 25')    // Mon Jun 25 2001
new Date('10')        // Mon Oct 01 2001
O V8 reconhece «jun» como junho pelas três primeiras letras e, sem ano, vai para 2001. Não lança nenhum erro: o evento fica guardado com a data de há 25 anos e desaparece de todas as listagens.
As regras que aplicamos, por esta ordem:
- Retirar o dia da semana do início («Martes, »).
- Testar os formatos numéricos explícitos:
DD.MM.YYYY,DD.MM,DD/MM/YYYY. - Testar nomes de meses em espanhol antes de
new Date(), e usar o ano corrente quando não há ano. - Usar
new Date()só no fim, e descartar números soltos e qualquer ano anterior a 2000. - Em intervalos como «Del 10 al 28 de junio», o início herda o mês e o ano do fim.
Cada formato estranho que aparece numa fonte nova passa a ser um caso de teste.
Uma interface, quatro implementações
O que permite misturar estratégias sem complicar o sistema é que todas devolvem o mesmo:
interface SourceStrategy {
  fetch(source: Source): Promise<RawItem[]>;
}
Um registo resolve a estratégia pela chave guardada em cada fonte (api, rss, html-scraper, dynamic). Depois, todos os resultados passam pelo mesmo normalizador (retirar HTML, limpar espaços, converter categorias em slugs, deduzir se é gratuito) e são guardados com uma chave única por fonte e identificador externo. Voltar a executar uma fonte atualiza o que já existia e não duplica nada.
Assim, mudar uma fonte de HTML para navegador headless, ou de direta para Bright Data, é mudar a sua configuração. O resto do pipeline nem dá por isso.
Checklist para o inventário de uma fonte
Antes de escrever código, para cada site:
- Há API pública, portal de dados abertos ou
/wp-json? - Que pedidos Fetch/XHR faz a página ao carregar?
- Tem RSS? Que data traz?
- O conteúdo está no HTML do servidor ou é desenhado pelo JavaScript?
- Que campos só estão na ficha de detalhe?
- Que formatos de data usa?
- Responde 403 a um cliente HTTP? E ao Playwright?
- O que dizem o seu robots.txt e os seus termos de utilização?
Se tem uma lista de fontes e quer saber de que estratégia precisa cada uma, no nosso serviço de web scraping começamos precisamente por essa ficha.