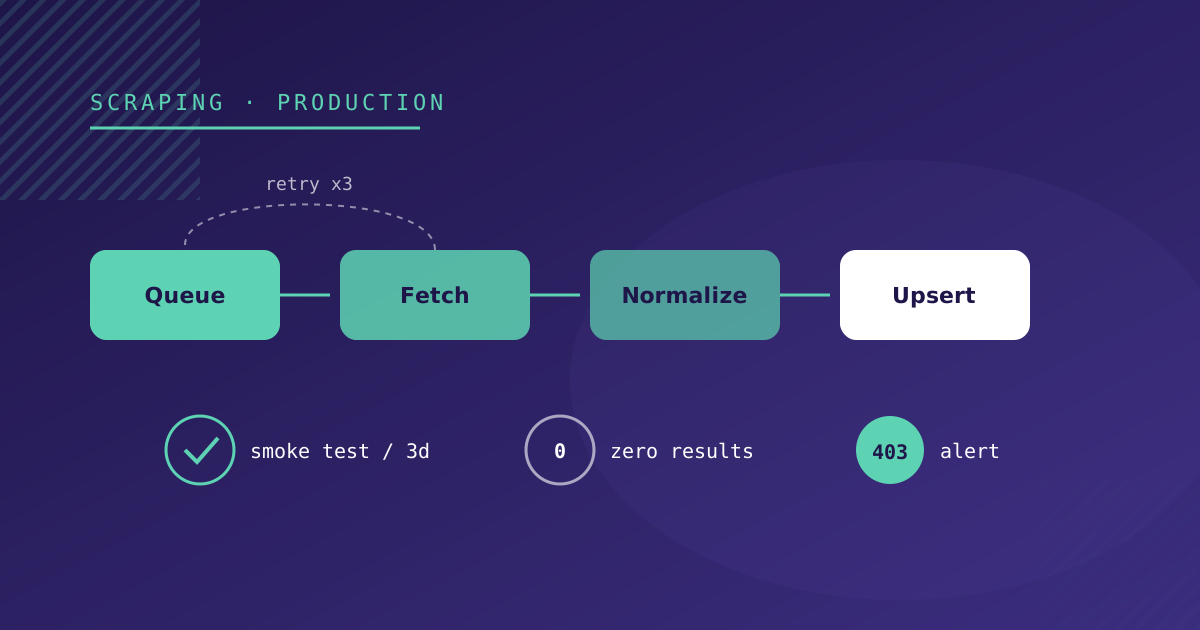
Uno scraper si rompe per motivi che non stanno nel tuo codice: il sito cambia design, sposta un URL, attiva un firewall o smette di pubblicare il feed. Nessuno di questi cambiamenti arriva con un preavviso, e se nessuno lo rileva, il primo sintomo è un utente che chiede perché mancano dei dati.
Manteniamo una piattaforma di aggregazione con più di 35 fonti pubbliche. Questo è ciò che abbiamo messo in piedi per accorgercene prima dell’utente, in ordine di quanto ci è stato utile.
Tre livelli di test, ognuno con il suo compito
| Livello | Contro cosa | Quando gira | Cosa rileva |
|---|---|---|---|
| Unitario | Una copia salvata della risposta reale | A ogni PR | Che il nostro parser capisce ancora il formato |
| Integrazione | Database di test | A ogni PR | Che normalizzare e salvare non duplica né perde campi |
| Smoke | Il sito reale | Ogni tre giorni in CI | Che la fonte c’è ancora e con la struttura che ci aspettiamo |
La distinzione conta perché i primi due non dovrebbero mai fallire per colpa di terzi. Se il test unitario chiamasse il sito reale, un redesign della fonte bloccherebbe qualsiasi PR, anche se non avesse niente a che fare con lo scraping.
Il test unitario usa una risposta reale salvata
Quando aggiungiamo una fonte, salviamo una risposta reale come fixture: il JSON dell’API, l’XML del feed o l’HTML dell’elenco. Il test elabora quel file e controlla campo per campo ciò che ne esce. Ogni formato strano che compare dopo (un prezzo vuoto, una data senza anno, una categoria con un altro nome) viene aggiunto alla fixture come nuovo caso.
Lo smoke test chiama il sito vero
Ce n’è uno per fonte ed è breve. Per una fonte HTML:
describe('Fonte X — smoke', () => {
  let html: string;

  beforeAll(async () => {
    const res = await axios.get(URL, { timeout: 30_000, headers: DEFAULT_HEADERS });
    html = res.data;
  });

  it('restituisce HTML', () => expect(html).toContain('<html'));

  it("ha delle card nell'elenco", () => {
    const $ = cheerio.load(html);
    expect($('.views-row').length).toBeGreaterThanOrEqual(1);
  });

  it('la prima card ha un titolo', () => {
    const $ = cheerio.load(html);
    expect($('.views-row').first().find('h2 a, h3 a').text().trim()).not.toBe('');
  });
});
Non controlla quanti elementi ci sono, perché cambia ogni giorno. Controlla che la struttura da cui dipende lo scraper esista ancora. E nell’intestazione di ogni file lasciamo scritto cosa guardare se fallisce: l’URL, il CMS del sito e dove si trovano i selettori nella configurazione.
Girano su GitHub Actions ogni tre giorni (cron: '0 8 */3 * *') e si possono anche lanciare a mano. Tre giorni è il nostro compromesso tra non martellare i siti di origine e non metterci una settimana ad accorgerci di un redesign.
Ogni esecuzione lascia traccia
Ogni fonte è un job in una coda BullMQ su Redis. Uno scheduler controlla ogni ora quali fonti vanno eseguite in base alla loro frequenza e le mette in coda. Se un’esecuzione fallisce, viene ritentata tre volte con attesa esponenziale a partire da 30 secondi. Se la lanciamo a mano dal pannello, un solo tentativo: chi la lancia a mano sta guardando e vuole vedere subito l’errore.
Ogni esecuzione salva un record:
- stato (
RUNNING,SUCCESS,FAILED) - elementi trovati ed elementi nuovi
- messaggio di errore, se c’è
- inizio e fine
Così si risponde in fretta a «da quando non arriva niente da questa fonte?», che è la prima domanda quando qualcosa si guasta.
Il guasto che non lancia errori: zero risultati
Questo è il caso che abbiamo fatto più fatica a vedere. Un sito cambia la classe CSS delle sue card, il selettore non trova niente e lo scraper termina con successo: zero elementi, nessun errore, stato SUCCESS.
Per questo il report giornaliero non si limita a separare i successi dai fallimenti. Raggruppa le fonti in quattro liste:
- Riuscite, con elementi trovati e nuovi.
- Fallite, con l’errore.
- Con zero risultati, anche se sono terminate bene.
- Non eseguite nel periodo, il che di solito indica che la fonte è disattivata o che lo scheduler non l’ha messa in coda.
La terza lista è quella che ci ha fatto scoprire più problemi. Una fonte che porta sempre tra 10 e 20 elementi e un giorno ne porta zero si è rotta, anche se lo stato dice il contrario.
Un alert che dice cosa controllare
Quando un’esecuzione fallisce davvero, arriva un’email al team. L’abbiamo ampliata ogni volta che un alert ci costringeva ad aprire cinque schede per capirlo. Oggi include:
- fonte, strategia e configurazione
- codice HTTP e i primi caratteri della risposta
- stack trace dell’errore
- le ultime cinque esecuzioni di quella fonte
- un suggerimento in base al tipo di errore
I suggerimenti sono regole semplici sul codice HTTP, sul messaggio di errore e sulla strategia della fonte:
| Segnale | Suggerimento |
|---|---|
| 403 | Il sito blocca le richieste automatiche: controllare lo User-Agent, passare a browser headless o a un’uscita con sblocco |
| 404 | L’URL è cambiato |
| 429 | Limitazione delle richieste: ridurre la frequenza o aggiungere attese |
| 500, 502, 503 | Il sito di origine è giù; verificare a mano prima di indagare oltre |
| timeout, ECONNABORTED | Sito lento o irraggiungibile; rivedere il timeout |
| ENOTFOUND, ECONNREFUSED | Dominio cambiato o sito giù |
| Errore di lettura dell’HTML | La struttura è cambiata: rivedere i selettori |
| Errore di JSON nell’API | Il formato è cambiato: rivedere la mappatura dei campi |
Con questa tabella, la maggior parte degli alert si risolve senza aprire il codice. Anche chi non ha scritto lo scraper sa da dove partire.
Un documento per fonte
Ogni fonte ha un file Markdown con la sua configurazione, un esempio del formato dei dati, i problemi noti e ciò che resta da fare. Lo pretendiamo come il test: senza documento la fonte non viene registrata.
Il documento esiste perché ogni sito ha le sue stranezze, e la seconda volta che qualcuno le indaga si perde già tempo. Esempi reali dalla nostra tabella dei problemi noti:
- il prezzo arriva come stringa vuota e va trattato come «senza prezzo», non come 0
- il campo «gratuito» arriva come numero
0o1 - l’URL dell’API reindirizza a un altro dominio e bisogna seguire il redirect
- il sito risponde 403 anche se il suo robots.txt consente l’accesso
- il feed mescola tipi di contenuto e bisogna filtrarli in base al prefisso del
guid
Ciò che si rompe e non è la fonte
Non tutti i guasti vengono da fuori. Una delle nostre fonti con browser headless si è fermata perché un ambiente è stato deployato senza la variabile che indica dove si trova il binario di Chromium. L’errore diceva Executable doesn't exist at /root/.cache/ms-playwright/... e lo smoke test, che usa un client HTTP, restava verde perché il sito funzionava.
Da allora lo trattiamo come parte del deploy: l’immagine Docker installa Chromium, fissa il percorso tramite variabile d’ambiente e lo documentiamo nella pagina della strategia. Se l’ambiente non può ospitare un browser, l’alternativa è collegarsi a uno remoto; è ciò che facciamo con lo Scraping Browser di Bright Data sulle fonti che in più bloccano per IP.
Checklist operativa
- Test unitario con una risposta reale salvata, a ogni PR.
- Smoke test contro il sito reale, pianificato e separato dalle PR.
- Coda con retry e attesa esponenziale; un solo tentativo nelle esecuzioni manuali.
- Registro per esecuzione con trovati, nuovi ed errore.
- Report giornaliero che separi le fonti con zero risultati.
- Alert con codice HTTP, risposta, cronologia e suggerimento.
- Un documento per fonte con i suoi problemi noti.
Prima di questo, abbiamo spiegato come scegliamo la strategia per ogni fonte. E se hai scraper che si rompono senza che nessuno se ne accorga, nel nostro servizio di web scraping partiamo proprio dal mettere in piedi questo monitoraggio.