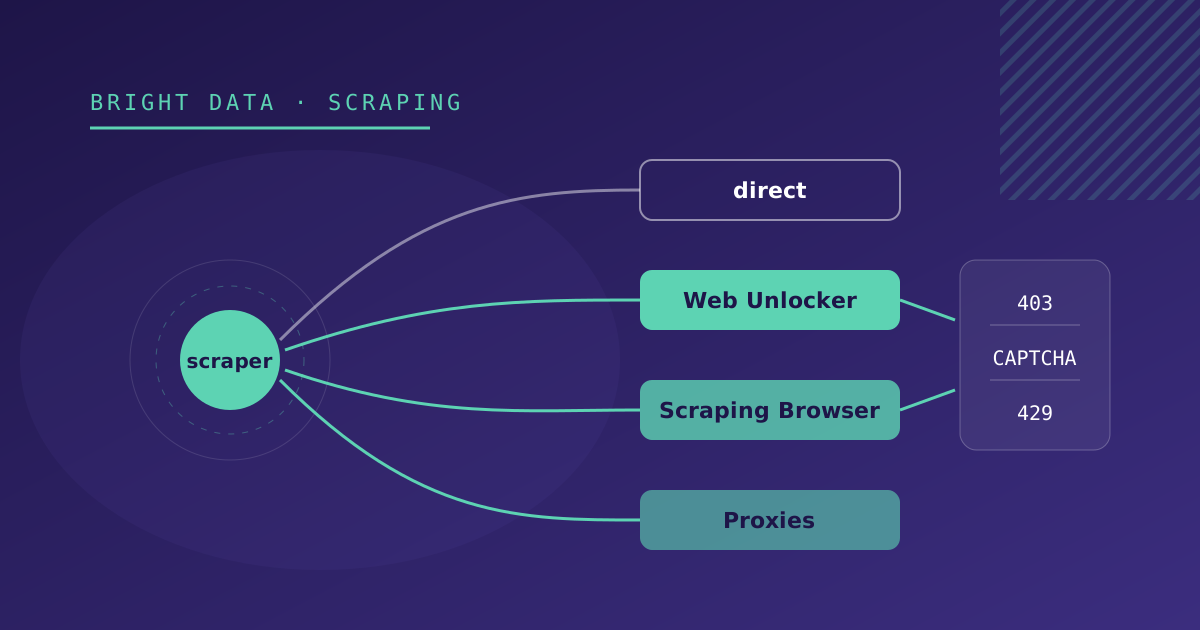
Há três sintomas que acabam na mesma pergunta. O site devolve 403 ao seu scraper. Ou responde com uma página de verificação em vez do conteúdo. Ou funciona durante alguns pedidos e depois responde 429 ou deixa de responder. A pergunta é se é preciso pagar a um fornecedor como a Bright Data.
Às vezes, sim. Mas antes de contratar o que quer que seja convém descartar o que é barato, porque uma parte dos bloqueios resolve-se numa linha de código. E, quando é preciso, convém ativá-lo só nas fontes que precisam.
Primeiro, descarte o que é barato
O User-Agent. O axios identifica-se por defeito como axios/1.x, e muitos sites bloqueiam esse User-Agent sem mais análise. Enviar os cabeçalhos de um navegador real (User-Agent, Accept, Accept-Language) desbloqueia mais fontes do que seria de esperar.
O ritmo. Um 429 é o site a pedir-lhe que vá mais devagar. Respeite o cabeçalho Retry-After, espace os pedidos e pergunte-se se precisa mesmo de consultar de hora a hora algo que muda uma vez por dia.
Um navegador headless próprio. Se o conteúdo é desenhado pelo JavaScript, o Playwright costuma bastar. Explicamo-lo em detalhe em como escolher a estratégia de cada fonte.
Se, mesmo assim, a fonte continuar a devolver 403, o bloqueio depende de algo que não controla a partir do seu servidor: a reputação do IP do seu centro de dados, a impressão digital do navegador ou um CAPTCHA. É aí que entra a Bright Data.
Que produto para cada sintoma
| Sintoma | Produto da Bright Data | Porquê |
|---|---|---|
| 403 ou página de verificação, com o conteúdo no HTML | Web Unlocker | Resolve CAPTCHAs, impressão digital e novas tentativas por trás de um único pedido |
| Bloqueio anti-bots numa página que precisa de JavaScript ou de interação | Scraping Browser | Navegador remoto com o desbloqueio incluído; o seu código de Playwright não muda |
| 429 ou bloqueio por IP ao fim de alguns pedidos | Proxies residenciais ou ISP | Distribuem os pedidos por IPs com melhor reputação |
| Conteúdo diferente consoante o país | Proxies com país fixo | O pedido sai a partir de um IP do país de que precisa |
| Resultados do Google ou do Bing | SERP API | Devolve os resultados já estruturados em JSON |
| Domínios grandes (marketplaces, perfis profissionais) | Web Scraper API ou Datasets | A Bright Data já mantém o extrator; o utilizador pede os dados |
Cada um contrata-se e configura-se como uma «zona» no painel da Bright Data, com as suas próprias credenciais. Isso permite usar vários num mesmo projeto, cada um nas fontes que precisam dele.
Web Unlocker: o que menos muda o seu código
O Web Unlocker pode ser usado de duas formas. A mais simples é como um proxy: o pedido sai igual ao de antes e a Bright Data trata do desbloqueio pelo caminho.
import axios from 'axios';
import { HttpsProxyAgent } from 'https-proxy-agent';

const { BRD_CUSTOMER, BRD_UNLOCKER_ZONE, BRD_UNLOCKER_PASSWORD } = process.env;

const agent = new HttpsProxyAgent(
  `http://brd-customer-${BRD_CUSTOMER}-zone-${BRD_UNLOCKER_ZONE}:${BRD_UNLOCKER_PASSWORD}@brd.superproxy.io:33335`,
);

const { data: html } = await axios.get(url, { httpsAgent: agent, proxy: false });
Como a Bright Data interceta a ligação HTTPS para a desbloquear, é preciso carregar o seu certificado CA no cliente (por exemplo com NODE_EXTRA_CA_CERTS). Desativar a verificação TLS para despachar é má ideia: afeta todo o processo, não só esse pedido.
A outra forma é a sua API REST: um POST para https://api.brightdata.com/request com a zona e o URL de destino, que devolve o HTML. É mais cómoda se o scraper corre num ambiente onde configurar um proxy é incómodo, como algumas funções serverless.
Nos dois casos, o que vem a seguir (cheerio, seletores, normalização) não muda.
Scraping Browser: o seu Playwright, com outro navegador
Se a fonte precisa de um navegador, o Scraping Browser substitui o Chromium que lança no seu servidor por um remoto na infraestrutura da Bright Data. A ligação faz-se por CDP:
import { chromium } from 'playwright';

const { BRD_CUSTOMER, BRD_BROWSER_ZONE, BRD_BROWSER_PASSWORD } = process.env;
const endpoint = `wss://brd-customer-${BRD_CUSTOMER}-zone-${BRD_BROWSER_ZONE}:${BRD_BROWSER_PASSWORD}@brd.superproxy.io:9222`;

const browser = await chromium.connectOverCDP(endpoint);
try {
  const page = await browser.newPage();
  await page.goto(url, { timeout: 120_000 });
  await page.waitForSelector('.agenda-item');
  // ...a mesma extração que com o navegador local
} finally {
  await browser.close();
}
O que muda em relação a um navegador local:
- Mais latência. O navegador está longe e faz o desbloqueio antes de lhe devolver a página. Suba os timeouts de navegação.
- Uma sessão por fonte. Abrimos o navegador, extraímos e fechamos. Manter sessões longas abertas consome e não acrescenta nada.
- Poupa o binário. Deixa de ser preciso instalar o Chromium na imagem Docker ou vigiar o seu caminho em cada ambiente, que é uma das causas de falha que temos documentadas em como vigiamos os scrapers em produção.
Proxies: quando o problema é o IP
Se o site não tem proteção anti-bots mas limita por IP, ou mostra conteúdo diferente consoante o país, bastam proxies. A Bright Data oferece quatro tipos:
- Datacenter: os mais baratos e rápidos, mas com IPs fáceis de identificar como não residenciais.
- ISP: IPs residenciais alojados em centros de dados. Estáveis e rápidos; bons para sessões longas.
- Residenciais: IPs de dispositivos reais. Os mais difíceis de bloquear.
- Móveis: IPs de operadoras móveis, para os casos mais exigentes.
Há dois parâmetros que se fixam no nome de utilizador do proxy:
-country-esfaz com que o pedido saia a partir de Espanha.-session-<id>mantém o mesmo IP entre pedidos, útil quando o site associa a paginação ou os cookies ao IP.
Integrá-la como mais uma estratégia
Quando integramos a Bright Data, o transporte passa a ser uma propriedade da fonte, não do código. Na configuração de cada fonte:
{
  "strategy": "html-scraper",
  "transport": "unlocker",
  "listUrl": "https://ejemplo.com/agenda"
}
com transport a direct, unlocker, browser ou proxy. O cliente HTTP ou o navegador são construídos a partir desse campo, e o resto do pipeline não sabe se o pedido passou pela Bright Data. Passar uma fonte para a Bright Data, ou devolvê-la à saída direta, é editar um campo.
As credenciais vão em variáveis de ambiente, uma zona por produto. Nunca na configuração da fonte, que costuma estar na base de dados e é vista por mais gente.
Controlar o consumo
A Bright Data cobra por utilização, e a unidade depende do produto: pedidos, GB transferidos ou resultados. Para que a fatura não surpreenda:
- Meça por fonte. Pedidos, taxa de sucesso e volume, guardados com cada execução. Uma fonte que de repente consome o triplo costuma estar a falhar e a repetir.
- Não peça fichas que já tem. Se a listagem traz um identificador estável, visite a ficha de detalhe só dos elementos novos.
- Ajuste a frequência. A fonte que muda uma vez por dia não precisa de ser executada de hora a hora.
- Reveja todos os meses que fontes podem voltar a sair diretas. Os sites mudam de fornecedor de proteção e, às vezes, aliviam-na.
O que a Bright Data não resolve
A Bright Data resolve o acesso técnico. Tudo o resto continua a ser trabalho seu:
- Os redesigns. Se o site mudar as suas classes CSS, o seletor falha na mesma. Os smoke tests continuam a ser necessários.
- As datas, os preços e os duplicados. A normalização é a mesma com ou sem desbloqueio.
- Os limites legais. Termos de utilização, direitos sobre bases de dados e RGPD, se houver dados pessoais, aplicam-se na mesma. A Bright Data tem ainda um processo de verificação de clientes e pode restringir certos destinos ou usos.
Se tem fontes que lhe devolvem 403 ou CAPTCHA, na nossa página de integração com a Bright Data explicamos como a montamos, e no serviço de web scraping como encaixa no resto do pipeline.