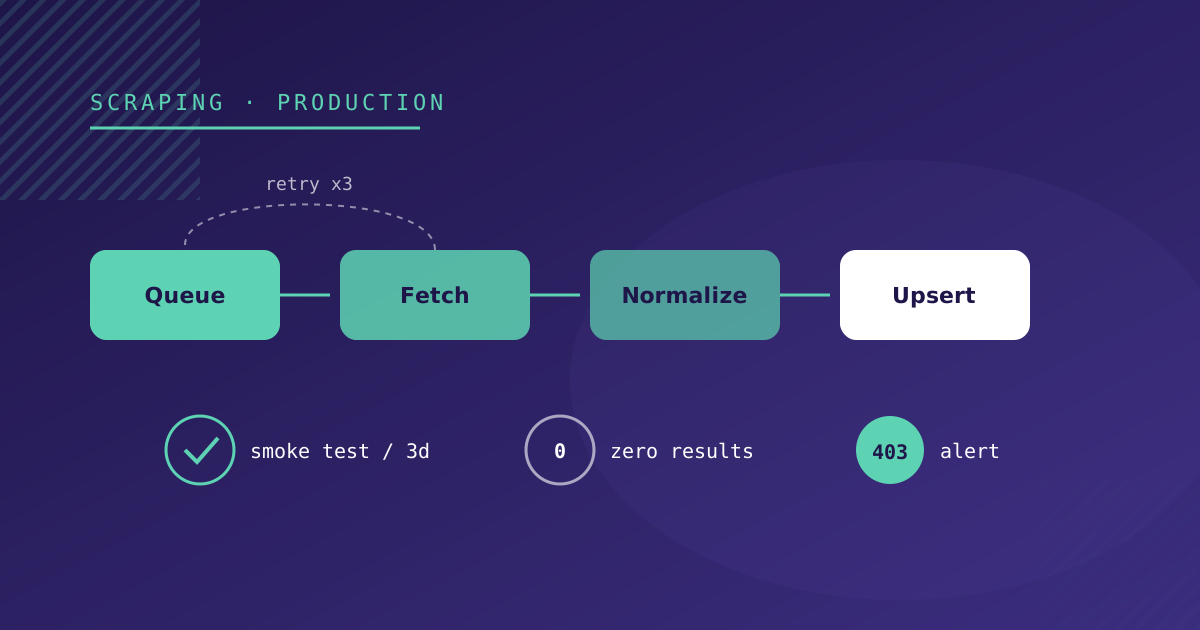
Un scraper se rompe por motivos que no están en tu código: la web cambia de diseño, mueve una URL, activa un firewall o deja de publicar el feed. Ninguno de esos cambios llega con aviso, y si nadie lo detecta, el primer síntoma es un usuario preguntando por qué faltan datos.
Mantenemos una plataforma de agregación con más de 35 fuentes públicas. Esto es lo que tenemos montado para enterarnos antes que el usuario, ordenado por lo que más nos ha ayudado.
Tres niveles de test, cada uno con su trabajo
| Nivel | Contra qué | Cuándo corre | Qué detecta |
|---|---|---|---|
| Unitario | Una captura guardada de la respuesta real | En cada PR | Que nuestro parser sigue entendiendo el formato |
| Integración | Base de datos de test | En cada PR | Que normalizar y guardar no duplica ni pierde campos |
| Smoke | La web real | Cada tres días en CI | Que la fuente sigue ahí y con la estructura que esperamos |
La distinción importa porque los dos primeros nunca deberían fallar por culpa de un tercero. Si el test unitario llamara a la web real, un rediseño de la fuente bloquearía cualquier PR, aunque no tuviera nada que ver con scraping.
El test unitario usa una respuesta real guardada
Cuando añadimos una fuente, guardamos una respuesta real como fixture: el JSON de la API, el XML del feed o el HTML del listado. El test procesa ese fichero y comprueba campo a campo lo que sale. Cada formato raro que aparece después (un precio vacío, una fecha sin año, una categoría con otro nombre) se añade al fixture como caso nuevo.
El smoke test llama a la web de verdad
Hay uno por fuente y es corto. Para una fuente de HTML:
describe('Fuente X — smoke', () => {
  let html: string;

  beforeAll(async () => {
    const res = await axios.get(URL, { timeout: 30_000, headers: DEFAULT_HEADERS });
    html = res.data;
  });

  it('devuelve HTML', () => expect(html).toContain('<html'));

  it('tiene tarjetas en el listado', () => {
    const $ = cheerio.load(html);
    expect($('.views-row').length).toBeGreaterThanOrEqual(1);
  });

  it('la primera tarjeta tiene título', () => {
    const $ = cheerio.load(html);
    expect($('.views-row').first().find('h2 a, h3 a').text().trim()).not.toBe('');
  });
});
No comprueba cuántos elementos hay, porque eso cambia cada día. Comprueba que la estructura de la que depende el scraper sigue existiendo. Y en la cabecera de cada fichero dejamos escrito qué mirar si falla: la URL, el CMS de la web y dónde están los selectores en la configuración.
Corren en GitHub Actions cada tres días (cron: '0 8 */3 * *') y también se pueden lanzar a mano. Tres días es nuestro compromiso entre no machacar las webs de origen y no tardar una semana en enterarnos de un rediseño.
Cada ejecución deja rastro
Cada fuente es un trabajo en una cola BullMQ sobre Redis. Un planificador revisa cada hora qué fuentes toca ejecutar según su frecuencia y las encola. Si una ejecución falla, se reintenta tres veces con espera exponencial empezando en 30 segundos. Si la lanzamos a mano desde el panel, un solo intento: cuando alguien la lanza a mano está mirando y quiere ver el error ya.
Cada ejecución guarda un registro:
- estado (
RUNNING,SUCCESS,FAILED) - elementos encontrados y elementos nuevos
- mensaje de error, si lo hay
- inicio y fin
Con eso se puede responder rápido a «¿desde cuándo no entra nada de esta fuente?», que es la primera pregunta cuando algo falla.
El fallo que no lanza ningún error: cero resultados
Este es el caso que más nos ha costado ver. Una web cambia la clase CSS de sus tarjetas, el selector no encuentra nada y el scraper termina con éxito: cero elementos, ningún error, estado SUCCESS.
Por eso el informe diario no se limita a separar éxitos de fallos. Agrupa las fuentes en cuatro listas:
- Con éxito, con elementos encontrados y nuevos.
- Fallidas, con el error.
- Con cero resultados, aunque hayan terminado bien.
- Sin ejecutar en el periodo, que suele indicar que la fuente está desactivada o que el planificador no la ha encolado.
La tercera lista es la que más problemas nos ha descubierto. Una fuente que siempre trae entre 10 y 20 elementos y un día trae cero se ha roto, aunque el estado diga lo contrario.
Una alerta que dice qué revisar
Cuando una ejecución falla de verdad, llega un email al equipo. Lo hemos ido ampliando cada vez que una alerta nos obligaba a abrir cinco pestañas para entenderla. Hoy incluye:
- fuente, estrategia y configuración
- código HTTP y los primeros caracteres de la respuesta
- traza del error
- las últimas cinco ejecuciones de esa fuente
- una sugerencia según el tipo de error
Las sugerencias son reglas sencillas sobre el código HTTP, el mensaje de error y la estrategia de la fuente:
| Señal | Sugerencia |
|---|---|
| 403 | La web bloquea peticiones automáticas: revisar el User-Agent, pasar a navegador headless o a una salida con desbloqueo |
| 404 | La URL ha cambiado |
| 429 | Limitación de peticiones: bajar la frecuencia o añadir esperas |
| 500, 502, 503 | La web de origen está caída; comprobar a mano antes de investigar más |
| timeout, ECONNABORTED | Web lenta o inaccesible; revisar el timeout |
| ENOTFOUND, ECONNREFUSED | Dominio cambiado o web caída |
| Error de lectura en HTML | Ha cambiado la estructura: revisar selectores |
| Error de JSON en API | Ha cambiado el formato: revisar el mapeo de campos |
Con esa tabla, la mayoría de las alertas se resuelven sin abrir el código. Una persona que no escribió el scraper sabe por dónde empezar.
Un documento por fuente
Cada fuente tiene un fichero Markdown con su configuración, un ejemplo del formato de datos, los problemas conocidos y lo pendiente. Lo exigimos igual que el test: sin documento no se da de alta la fuente.
El documento existe porque cada web tiene sus rarezas, y la segunda vez que alguien las investiga ya se pierde tiempo. Ejemplos reales de nuestra tabla de problemas conocidos:
- el precio llega como cadena vacía y hay que tratarlo como «sin precio», no como 0
- el campo «gratuito» viene como número
0o1 - la URL de la API redirige a otro dominio y hay que seguir la redirección
- la web responde 403 aunque su robots.txt permite el acceso
- el feed mezcla tipos de contenido y hay que filtrarlos por el prefijo del
guid
Lo que se rompe y no es la fuente
No todo fallo viene de fuera. Una de nuestras fuentes con navegador headless se cayó porque un entorno se desplegó sin la variable que indica dónde está el binario de Chromium. El error decía Executable doesn't exist at /root/.cache/ms-playwright/... y el smoke test, que usa un cliente HTTP, seguía en verde porque la web estaba bien.
Desde entonces lo tratamos como parte del despliegue: la imagen Docker instala Chromium, fija la ruta por variable de entorno y lo documentamos en la página de la estrategia. Si el entorno no puede llevar un navegador, la alternativa es conectarse a uno remoto; es lo que hacemos con el Scraping Browser de Bright Data en las fuentes que además bloquean por IP.
Checklist de operación
- Test unitario con una respuesta real guardada, en cada PR.
- Smoke test contra la web real, programado y separado de los PR.
- Cola con reintentos y espera exponencial; un solo intento en ejecuciones manuales.
- Registro por ejecución con encontrados, nuevos y error.
- Informe diario que separe las fuentes con cero resultados.
- Alerta con código HTTP, respuesta, historial y sugerencia.
- Un documento por fuente con sus problemas conocidos.
Antes de esto, explicamos cómo elegimos la estrategia de cada fuente. Y si tienes scrapers que se rompen sin que nadie se entere, en nuestro servicio de web scraping empezamos por montar esta vigilancia.