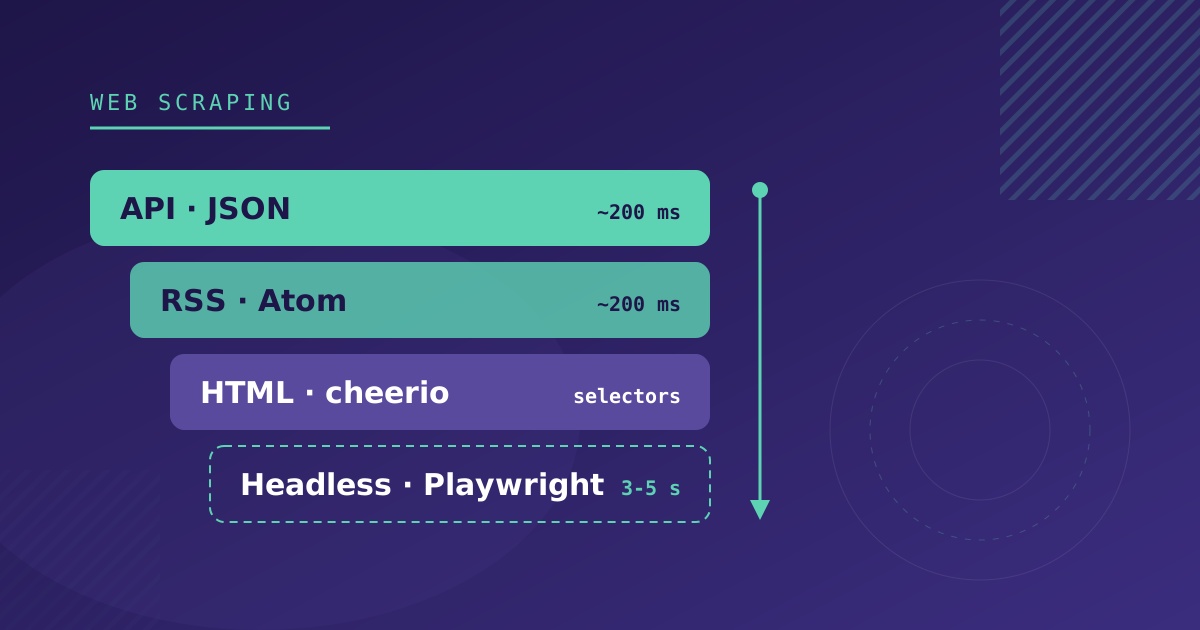
Quando ci arriva una lista di siti da cui estrarre dati, la tentazione è aprire Playwright e iniziare a scrivere selettori. Delle quattro strategie che usiamo è la più lenta, quella che consuma più memoria e quella che si rompe più spesso.
In un progetto di aggregazione che manteniamo, con più di 35 fonti pubbliche (portali open data, siti in WordPress, Drupal, React e qualcuno fatto a mano), siamo arrivati a quattro strategie dietro un’unica interfaccia e a una regola per scegliere tra loro: la prima della lista che la fonte consente.
Le quattro strategie, dalla più stabile alla più fragile
| Strategia | Quando | Costo | Cosa si rompe |
|---|---|---|---|
| API pubblica o interna | Il sito carica i dati da un JSON | ~200 ms per richiesta | Cambi di schema, poco frequenti |
| RSS / Atom | C’è un feed e bastano titolo, link e riassunto | ~200 ms per feed | La data del feed non è quella del contenuto |
| HTML statico | Il contenuto arriva nell’HTML del server | Una richiesta per elenco, più le schede | I selettori, a ogni redesign |
| Browser headless | JavaScript, scroll infinito, «carica altro» | 3-5 s per pagina, 100-200 MB di RAM | Tempi di attesa e il binario del browser |
Scendere di un gradino costa velocità e stabilità. Per questo l’inventario di ogni fonte parte sempre dall’alto.
1. Cerca l’API prima di guardare l’HTML
Molti più siti di quanto sembri caricano i dati da un JSON. Ci sono tre posti dove guardare, in quest’ordine.
Portali open data. Molte pubbliche amministrazioni pubblicano i loro dataset in JSON o CSV con licenza di riutilizzo. Sono la fonte migliore possibile, anche se non la più pulita. In uno dei nostri, il prezzo arriva come stringa vuota quando non c’è prezzo, il campo «gratuito» arriva come 0 o 1 numerico e l’indirizzo è un oggetto annidato con chiavi con trattino (street-address) che la nostra mappatura per percorsi con punti non risolveva al primo colpo. Nessuno di questi dettagli è nella documentazione del portale: emergono elaborando la prima risposta reale.
WordPress. Una parte enorme dei siti piccoli e medi è WordPress, e molti lasciano aperta la REST API. Prova /wp-json/wp/v2/posts. Se il sito usa un plugin di calendario come The Events Calendar, /wp-json/tribe/events/v1/events restituisce gli eventi con data di inizio, data di fine, luogo e costo già strutturati. Tre delle nostre fonti, che a prima vista richiedevano uno scraper HTML, escono così.
La scheda Network. Apri i DevTools, filtra per Fetch/XHR e ricarica. Se il sito è una SPA, i dati arrivano da qualche endpoint, che spesso accetta parametri di data e paginazione. Una delle nostre fonti, una biglietteria online, restituisce solo una finestra di due settimane, quindi l’URL salvato nella configurazione contiene dei segnaposto che si risolvono a ogni esecuzione:
https://ejemplo.com/api/sesiones?desde={{today}}&hasta={{today+14}}Prima di usare un endpoint interno conviene leggere i termini d’uso del sito. Che un JSON sia accessibile non significa che il suo riutilizzo sia consentito.
2. RSS, veloce ma con una trappola nella data
Un feed RSS si elabora in millisecondi e non cambia quasi mai formato. Il problema è ciò che non contiene. Il pubDate di ogni elemento è la data in cui è stato pubblicato l’articolo, non quella dell’evento, dell’offerta o del prodotto di cui parla. E non ci sono prezzo, luogo né data di fine.
Inoltre i feed dei media mescolano i contenuti. Uno di quelli che usiamo include articoli, schede di locali e guide nello stesso canale; il guid ha un prefisso per tipo (Content-Venue-213605, Content-Article-…) ed è ciò che permette di separarli.
Usiamo l’RSS come fonte di scoperta: rileva che c’è qualcosa di nuovo e, se serve, visitiamo la scheda per completare i dati.
3. HTML statico, con i selettori in configurazione
Quando il contenuto arriva nell’HTML restituito dal server, bastano una richiesta HTTP e cheerio. La decisione che qui ci ha fatto risparmiare più tempo è tenere i selettori nella configurazione della fonte e non nel codice:
{
  "listUrl": "https://ejemplo.com/agenda",
  "selectors": {
    "card": ".agenda-item",
    "title": ".agenda-item__title",
    "link": "a",
    "date": ".agenda-item__date",
    "image": "img"
  }
}
Quando il sito cambia design, la correzione consiste nel modificare quel JSON. Non serve fare un deploy.
Due casi da prevedere:
- Classi con hash. I siti fatti con Gatsby o Next.js e CSS Modules generano classi come
card-module--title--a1b2c, e l’hash cambia a ogni build del sito. Il selettore deve andare per prefisso:[class*="card-module--title"]. - Elenchi incompleti. Se la card dell’elenco non porta la descrizione, bisogna visitare la scheda di ogni elemento. Lo facciamo a lotti con concorrenza limitata e solo per gli elementi che non ce l’hanno già.
4. Browser headless, quando non resta altro
Playwright serve in tre situazioni: il contenuto viene disegnato con JavaScript, la pagina carica altri risultati con lo scroll o con un pulsante «carica altro», oppure il sito rifiuta qualsiasi client HTTP che non sia un browser.
Cosa abbiamo imparato mantenendolo:
- Aspetta un selettore preciso, non un tempo fisso.
waitForSelector('.agenda-item')è affidabile;waitForTimeout(3000)fallisce il giorno in cui il sito è lento. networkidlepuò non arrivare mai nei siti con analytics o chat che continuano a fare richieste. Dopo aver cliccato «carica altro» accettiamo il timeout dinetworkidlee controlliamo se sono comparse nuove card.- Chiudi il browser in un
finally. Ogni istanza di Chromium occupa tra 100 e 200 MB, e un browser che resta aperto dopo un’eccezione finisce per mandare giù il worker. - Il binario fa parte del deploy. Lanciamo Chromium da un percorso fissato tramite variabile d’ambiente, e l’immagine Docker lo installa. Un ambiente rimasto senza quella variabile ha avuto una fonte ferma con
browserType.launch: Executable doesn't exist, e il codice non aveva alcun difetto.
Un browser proprio non risolve tutti i blocchi. Diverse nostre fonti restituiscono 403 a qualsiasi client HTTP, una di esse con il robots.txt aperto. Se il blocco dipende dall’IP o dall’impronta del browser, nemmeno un Playwright lanciato da un server in datacenter passa. Per questi casi integriamo Bright Data sulla singola fonte, senza toccare le altre.
Il problema che hanno tutte: le date in spagnolo
La strategia non conta: alla fine bisogna convertire testo in date. Nelle nostre fonti convivono «Del 10 al 28 de junio», «Martes, 3 de marzo», «jun 25», «25.06» e «25/06/2026».
La trappola sta nel Date di JavaScript. In Node:
new Date('25 junio')  // Mon Jun 25 2001
new Date('jun 25')    // Mon Jun 25 2001
new Date('10')        // Mon Oct 01 2001
V8 riconosce «jun» come giugno dalle prime tre lettere e, senza anno, va al 2001. Non lancia alcun errore: l’evento viene salvato con una data di 25 anni fa e sparisce da tutti gli elenchi.
Le regole che applichiamo, in quest’ordine:
- Togliere il giorno della settimana all’inizio («Martes, »).
- Provare i formati numerici espliciti:
DD.MM.YYYY,DD.MM,DD/MM/YYYY. - Provare i nomi dei mesi in spagnolo prima di
new Date(), e usare l’anno in corso quando l’anno manca. - Usare
new Date()solo alla fine, e scartare i numeri isolati e qualsiasi anno precedente al 2000. - Negli intervalli come «Del 10 al 28 de junio», l’inizio eredita mese e anno dalla fine.
Ogni formato strano che compare in una nuova fonte diventa un caso di test.
Un’interfaccia, quattro implementazioni
Ciò che permette di mescolare strategie senza complicare il sistema è che tutte restituiscono la stessa cosa:
interface SourceStrategy {
  fetch(source: Source): Promise<RawItem[]>;
}
Un registro risolve la strategia in base alla chiave salvata in ogni fonte (api, rss, html-scraper, dynamic). Poi tutti i risultati passano dallo stesso normalizzatore (rimuovere l’HTML, pulire gli spazi, convertire le categorie in slug, dedurre se è gratuito) e vengono salvati con una chiave univoca per fonte e identificativo esterno. Rieseguire una fonte aggiorna ciò che esisteva già e non duplica nulla.
Così, passare una fonte da HTML a browser headless, o da diretta a Bright Data, significa cambiarne la configurazione. Il resto della pipeline non se ne accorge.
Checklist per l’inventario di una fonte
Prima di scrivere codice, per ogni sito:
- C’è un’API pubblica, un portale open data o
/wp-json? - Quali richieste Fetch/XHR fa la pagina al caricamento?
- Ha un RSS? Che data riporta?
- Il contenuto è nell’HTML del server o lo disegna JavaScript?
- Quali campi sono solo nella scheda di dettaglio?
- Quali formati di data usa?
- Risponde 403 a un client HTTP? E a Playwright?
- Cosa dicono il suo robots.txt e i suoi termini d’uso?
Se hai una lista di fonti e vuoi sapere quale strategia serve a ciascuna, nel nostro servizio di web scraping partiamo proprio da quella scheda.