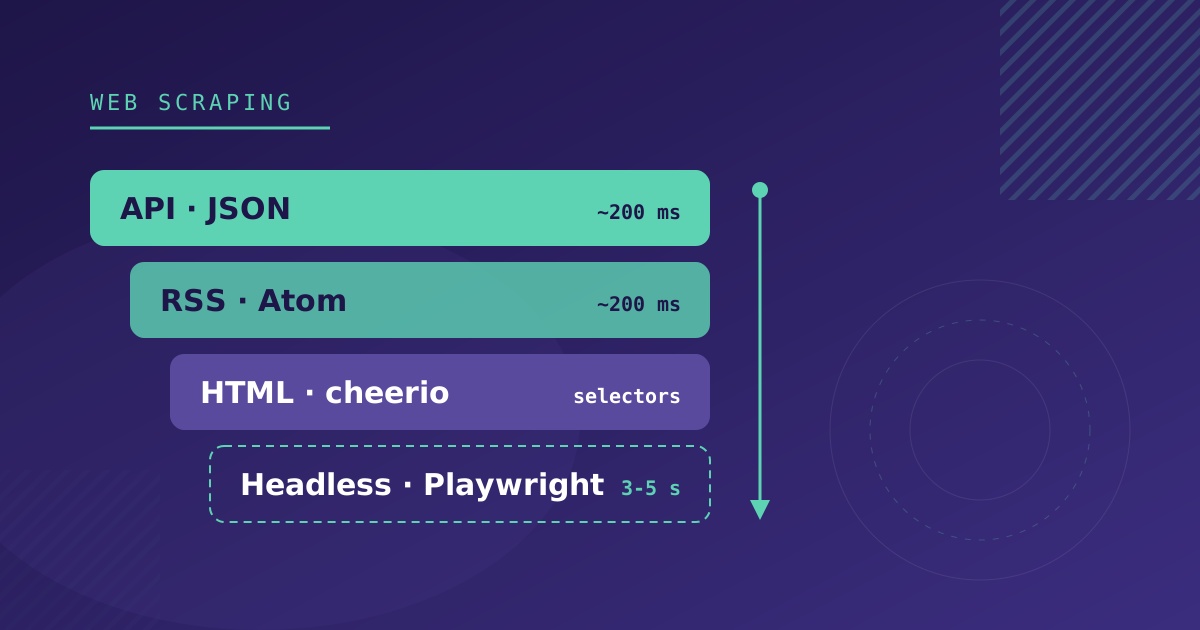
Cuando nos llega una lista de webs de las que sacar datos, la tentación es abrir Playwright y empezar a escribir selectores. De las cuatro estrategias que usamos es la más lenta, la que más memoria gasta y la que más se rompe.
En un proyecto de agregación que mantenemos, con más de 35 fuentes públicas (portales de datos abiertos, webs en WordPress, Drupal, React y alguna hecha a mano), acabamos con cuatro estrategias detrás de una misma interfaz y una regla para elegir entre ellas: la primera de la lista que la fuente permita.
Las cuatro estrategias, de la más estable a la más frágil
| Estrategia | Cuándo | Coste | Qué se rompe |
|---|---|---|---|
| API pública o interna | La web carga sus datos desde un JSON | ~200 ms por petición | Cambios de esquema, poco frecuentes |
| RSS / Atom | Hay un feed y bastan título, enlace y resumen | ~200 ms por feed | La fecha del feed no es la del contenido |
| HTML estático | El contenido viene en el HTML del servidor | Una petición por listado, más las fichas | Los selectores, en cada rediseño |
| Navegador headless | JavaScript, scroll infinito, «cargar más» | 3-5 s por página, 100-200 MB de RAM | Tiempos de espera y el binario del navegador |
Bajar un escalón cuesta velocidad y estabilidad. Por eso el inventario de cada fuente empieza siempre por arriba.
1. Busca la API antes de mirar el HTML
Muchas más webs de las que parece cargan sus datos desde un JSON. Hay tres sitios donde mirar, en este orden.
Portales de datos abiertos. Muchas administraciones publican sus conjuntos de datos en JSON o CSV con licencia de reutilización. Son la mejor fuente posible, aunque no la más limpia. En uno de los nuestros, el precio llega como cadena vacía cuando no hay precio, el campo «gratuito» viene como 0 o 1 numérico y la dirección es un objeto anidado con claves con guion (street-address) que nuestro mapeo por rutas con puntos no resolvía a la primera. Ninguno de esos detalles está en la documentación del portal: salen al procesar la primera respuesta real.
WordPress. Una parte enorme de las webs pequeñas y medianas son WordPress, y muchas dejan abierta su REST API. Prueba /wp-json/wp/v2/posts. Si la web usa un plugin de calendario como The Events Calendar, /wp-json/tribe/events/v1/events devuelve los eventos con fecha de inicio, fecha de fin, lugar y coste ya estructurados. Tres de nuestras fuentes, que a simple vista pedían un scraper de HTML, salen así.
La pestaña Network. Abre las DevTools, filtra por Fetch/XHR y recarga. Si la web es una SPA, los datos vienen de algún endpoint, y a menudo acepta parámetros de fecha y paginación. Una de nuestras fuentes, una taquilla online, solo devuelve una ventana de dos semanas, así que la URL guardada en la configuración lleva marcadores que se resuelven en cada ejecución:
https://ejemplo.com/api/sesiones?desde={{today}}&hasta={{today+14}}Antes de usar un endpoint interno conviene leer los términos de uso de la web. Que un JSON sea accesible no significa que su reutilización esté permitida.
2. RSS, rápido pero con una trampa en la fecha
Un feed RSS se procesa en milisegundos y casi nunca cambia de formato. El problema es lo que no trae. El pubDate de cada elemento es la fecha en que se publicó el artículo, no la del evento, la oferta o el producto del que habla. Y no hay precio, ni lugar, ni fecha de fin.
Además, los feeds de medios mezclan contenidos. Uno de los que usamos incluye artículos, fichas de locales y guías en el mismo canal; el guid lleva un prefijo por tipo (Content-Venue-213605, Content-Article-…) y es lo que permite separarlos.
Usamos RSS como fuente de descubrimiento: detecta que hay algo nuevo y, si hace falta, visitamos la ficha para completar los datos.
3. HTML estático, con los selectores en configuración
Cuando el contenido viene en el HTML que devuelve el servidor, basta con una petición HTTP y cheerio. La decisión que más tiempo nos ha ahorrado aquí es guardar los selectores en la configuración de la fuente y no en el código:
{
  "listUrl": "https://ejemplo.com/agenda",
  "selectors": {
    "card": ".agenda-item",
    "title": ".agenda-item__title",
    "link": "a",
    "date": ".agenda-item__date",
    "image": "img"
  }
}
Cuando la web cambia de diseño, el arreglo es editar ese JSON. No hay que desplegar.
Dos casos que conviene prever:
- Clases con hash. Las webs hechas con Gatsby o Next.js y CSS Modules generan clases como
card-module--title--a1b2c, y el hash cambia en cada build de la web. El selector tiene que ir por prefijo:[class*="card-module--title"]. - Listados incompletos. Si la tarjeta del listado no trae descripción, hay que visitar la ficha de cada elemento. Lo hacemos en lotes con concurrencia limitada y solo para los elementos que no la tienen ya.
4. Navegador headless, cuando no queda otra
Playwright hace falta en tres situaciones: el contenido se pinta con JavaScript, la página carga más resultados al hacer scroll o con un botón de «cargar más», o la web rechaza a cualquier cliente HTTP que no sea un navegador.
Lo que hemos aprendido manteniéndolo:
- Espera a un selector concreto, no a un tiempo fijo.
waitForSelector('.agenda-item')es fiable;waitForTimeout(3000)falla el día que la web va lenta. networkidlepuede no llegar nunca en webs con analítica o chat que no paran de hacer peticiones. Tras pulsar «cargar más» aceptamos el timeout denetworkidley comprobamos si han aparecido tarjetas nuevas.- Cierra el navegador en un
finally. Cada instancia de Chromium ocupa entre 100 y 200 MB, y un navegador que se queda abierto tras una excepción acaba tumbando el worker. - El binario es parte del despliegue. Lanzamos Chromium desde una ruta fijada por variable de entorno, y la imagen Docker lo instala. Un entorno que se quedó sin esa variable tuvo una fuente caída con
browserType.launch: Executable doesn't exist, y el código no tenía ningún fallo.
Un navegador propio no resuelve todos los bloqueos. Varias de nuestras fuentes devuelven 403 a cualquier cliente HTTP, una de ellas con el robots.txt abierto. Si el bloqueo depende de la IP o de la huella del navegador, un Playwright lanzado desde un servidor de centro de datos tampoco pasa. Para esos casos integramos Bright Data en la fuente concreta, sin tocar las demás.
El problema que comparten todas: las fechas en español
Da igual la estrategia: al final hay que convertir texto en fechas. En nuestras fuentes conviven «Del 10 al 28 de junio», «Martes, 3 de marzo», «jun 25», «25.06» y «25/06/2026».
La trampa está en el Date de JavaScript. En Node:
new Date('25 junio')  // Mon Jun 25 2001
new Date('jun 25')    // Mon Jun 25 2001
new Date('10')        // Mon Oct 01 2001
V8 reconoce «jun» como junio por las tres primeras letras y, sin año, se va a 2001. No lanza ningún error: el evento se guarda con fecha de hace 25 años y desaparece de todos los listados.
Las reglas que aplicamos, en este orden:
- Quitar el día de la semana del principio («Martes, »).
- Probar los formatos numéricos explícitos:
DD.MM.YYYY,DD.MM,DD/MM/YYYY. - Probar nombres de mes en español antes que
new Date(), y usar el año en curso cuando no hay año. - Usar
new Date()solo al final, y descartar números sueltos y cualquier año anterior a 2000. - En rangos como «Del 10 al 28 de junio», el inicio hereda mes y año del final.
Cada formato raro que aparece en una fuente nueva se convierte en un caso de test.
Una interfaz, cuatro implementaciones
Lo que permite mezclar estrategias sin que el sistema se complique es que todas devuelven lo mismo:
interface SourceStrategy {
  fetch(source: Source): Promise<RawItem[]>;
}
Un registro resuelve la estrategia por la clave guardada en cada fuente (api, rss, html-scraper, dynamic). Después, todos los resultados pasan por el mismo normalizador (quitar HTML, limpiar espacios, convertir categorías en slugs, deducir si es gratuito) y se guardan con una clave única por fuente e identificador externo. Reejecutar una fuente actualiza lo que ya existía y no duplica nada.
Así, cambiar una fuente de HTML a navegador headless, o de directa a Bright Data, es cambiar su configuración. El resto del pipeline no se entera.
Checklist para el inventario de una fuente
Antes de escribir código, para cada web:
- ¿Hay API pública, portal de datos abiertos o
/wp-json? - ¿Qué peticiones Fetch/XHR hace la página al cargar?
- ¿Tiene RSS? ¿Qué fecha trae?
- ¿El contenido está en el HTML del servidor o lo pinta JavaScript?
- ¿Qué campos solo están en la ficha de detalle?
- ¿Qué formatos de fecha usa?
- ¿Responde 403 a un cliente HTTP? ¿Y a Playwright?
- ¿Qué dicen su robots.txt y sus términos de uso?
Si tienes una lista de fuentes y quieres saber qué estrategia necesita cada una, en nuestro servicio de web scraping empezamos justo por esa ficha.