Wenn wir eine Liste von Websites bekommen, aus denen Daten geholt werden sollen, ist die Versuchung groß, Playwright zu öffnen und Selektoren zu schreiben. Von den vier Strategien, die wir einsetzen, ist das die langsamste, die mit dem höchsten Speicherverbrauch und die, die am häufigsten kaputtgeht.
In einem Aggregationsprojekt, das wir betreuen, mit mehr als 35 öffentlichen Quellen (Open-Data-Portale, Websites auf WordPress, Drupal, React und einige handgebaute), sind wir bei vier Strategien hinter derselben Schnittstelle gelandet und bei einer Regel, um zwischen ihnen zu wählen: die erste der Liste, die die Quelle zulässt.
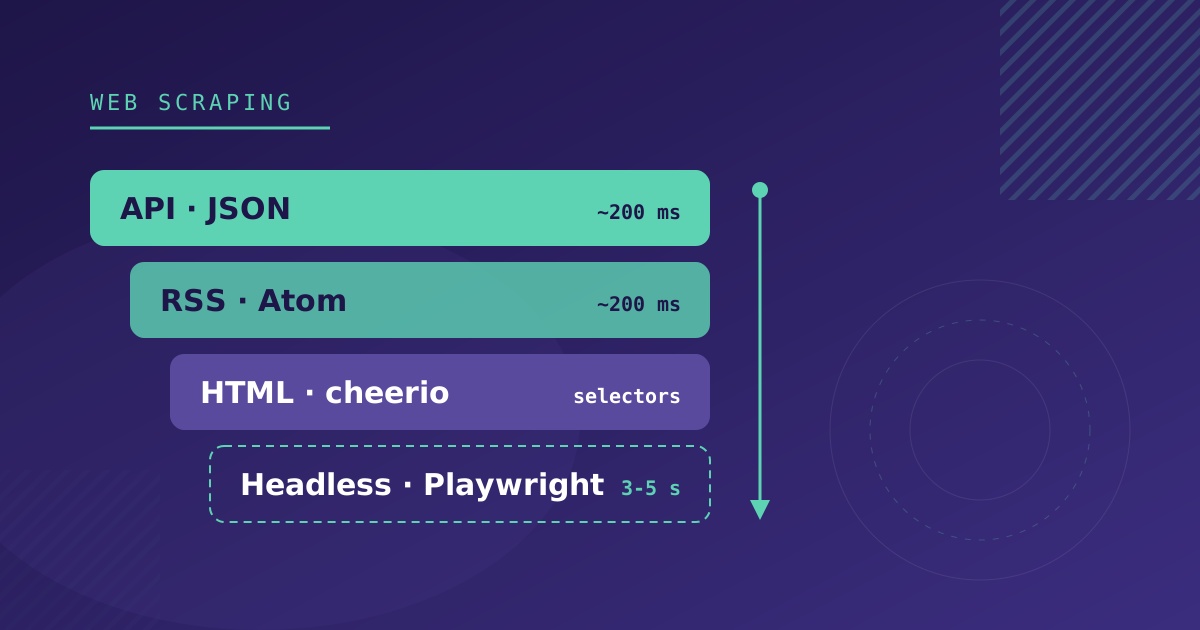
Die vier Strategien, von der stabilsten zur fragilsten
| Strategie | Wann | Kosten | Was kaputtgeht |
|---|---|---|---|
| Öffentliche oder interne API | Die Website lädt ihre Daten aus einem JSON | ~200 ms pro Anfrage | Schemaänderungen, selten |
| RSS / Atom | Es gibt einen Feed, und Titel, Link und Zusammenfassung reichen | ~200 ms pro Feed | Das Datum im Feed ist nicht das des Inhalts |
| Statisches HTML | Der Inhalt steckt im HTML des Servers | Eine Anfrage pro Liste, plus die Detailseiten | Die Selektoren, bei jedem Redesign |
| Headless-Browser | JavaScript, Infinite Scroll, „Mehr laden“ | 3-5 s pro Seite, 100-200 MB RAM | Timeouts und das Browser-Binary |
Jede Stufe nach unten kostet Geschwindigkeit und Stabilität. Deshalb beginnt die Bestandsaufnahme jeder Quelle immer oben.
1. Suchen Sie die API, bevor Sie sich das HTML ansehen
Weit mehr Websites, als man denkt, laden ihre Daten aus einem JSON. Es gibt drei Stellen, an denen Sie nachsehen sollten, in dieser Reihenfolge.
Open-Data-Portale. Viele Behörden veröffentlichen ihre Datensätze als JSON oder CSV mit einer Lizenz zur Weiterverwendung. Sie sind die bestmögliche Quelle, wenn auch nicht die sauberste. Bei einem unserer Portale kommt der Preis als leerer String, wenn es keinen Preis gibt, das Feld „kostenlos“ als numerisches 0 oder 1, und die Adresse ist ein verschachteltes Objekt mit Schlüsseln mit Bindestrich (street-address), die unser Mapping über Punkt-Pfade nicht auf Anhieb auflöste. Keines dieser Details steht in der Dokumentation des Portals: Sie zeigen sich erst bei der ersten echten Antwort.
WordPress. Ein riesiger Teil der kleinen und mittleren Websites läuft auf WordPress, und viele lassen ihre REST API offen. Probieren Sie /wp-json/wp/v2/posts. Nutzt die Website ein Kalender-Plugin wie The Events Calendar, liefert /wp-json/tribe/events/v1/events die Veranstaltungen mit Start- und Enddatum, Ort und Kosten bereits strukturiert. Drei unserer Quellen, die auf den ersten Blick nach einem HTML-Scraper verlangten, laufen so.
Der Network-Tab. Öffnen Sie die DevTools, filtern Sie nach Fetch/XHR und laden Sie neu. Ist die Website eine SPA, kommen die Daten von irgendeinem Endpoint, und oft akzeptiert er Datums- und Paginierungsparameter. Eine unserer Quellen, ein Online-Ticketshop, liefert nur ein Fenster von zwei Wochen. Die in der Konfiguration gespeicherte URL enthält deshalb Platzhalter, die bei jedem Lauf aufgelöst werden:
https://ejemplo.com/api/sesiones?desde={{today}}&hasta={{today+14}}Bevor Sie einen internen Endpoint nutzen, lesen Sie die Nutzungsbedingungen der Website. Dass ein JSON erreichbar ist, heißt nicht, dass seine Weiterverwendung erlaubt ist.
2. RSS: schnell, aber mit einer Falle beim Datum
Ein RSS-Feed ist in Millisekunden verarbeitet und ändert sein Format fast nie. Das Problem ist, was er nicht enthält. Das pubDate jedes Eintrags ist das Datum, an dem der Artikel veröffentlicht wurde, nicht das der Veranstaltung, des Angebots oder des Produkts, um das es geht. Und es gibt keinen Preis, keinen Ort und kein Enddatum.
Außerdem mischen die Feeds von Medien ihre Inhalte. Einer der Feeds, die wir nutzen, enthält Artikel, Einträge zu Lokalen und Guides im selben Kanal. Die guid trägt ein Präfix pro Typ (Content-Venue-213605, Content-Article-…), und darüber lassen sie sich trennen.
Wir nutzen RSS als Entdeckungsquelle: Der Feed meldet, dass es etwas Neues gibt, und wenn nötig besuchen wir die Detailseite, um die Daten zu vervollständigen.
3. Statisches HTML, mit den Selektoren in der Konfiguration
Steckt der Inhalt im HTML, das der Server ausliefert, reichen eine HTTP-Anfrage und cheerio. Die Entscheidung, die uns hier am meisten Zeit gespart hat: Die Selektoren liegen in der Konfiguration der Quelle und nicht im Code.
{
  "listUrl": "https://ejemplo.com/agenda",
  "selectors": {
    "card": ".agenda-item",
    "title": ".agenda-item__title",
    "link": "a",
    "date": ".agenda-item__date",
    "image": "img"
  }
}
Ändert die Website ihr Design, besteht die Reparatur darin, dieses JSON zu bearbeiten. Ein Deployment ist nicht nötig.
Zwei Fälle, auf die Sie vorbereitet sein sollten:
- Klassen mit Hash. Websites, die mit Gatsby oder Next.js und CSS Modules gebaut sind, erzeugen Klassen wie
card-module--title--a1b2c, und der Hash ändert sich bei jedem Build der Website. Der Selektor muss über das Präfix gehen:[class*="card-module--title"]. - Unvollständige Listen. Bringt die Karte in der Liste keine Beschreibung mit, muss die Detailseite jedes Eintrags besucht werden. Das machen wir in Batches mit begrenzter Parallelität und nur für Einträge, die die Beschreibung noch nicht haben.
4. Headless-Browser, wenn nichts anderes bleibt
Playwright ist in drei Situationen nötig: Der Inhalt wird mit JavaScript gerendert, die Seite lädt beim Scrollen oder über einen „Mehr laden“-Button weitere Ergebnisse nach, oder die Website lehnt jeden HTTP-Client ab, der kein Browser ist.
Was wir beim Betrieb gelernt haben:
- Warten Sie auf einen bestimmten Selektor, nicht auf eine feste Zeit.
waitForSelector('.agenda-item')ist zuverlässig;waitForTimeout(3000)schlägt an dem Tag fehl, an dem die Website langsam ist. networkidletritt manchmal nie ein, auf Websites mit Analytics oder Chat, die ständig Anfragen schicken. Nach dem Klick auf „Mehr laden“ nehmen wir dennetworkidle-Timeout in Kauf und prüfen, ob neue Karten aufgetaucht sind.- Schließen Sie den Browser in einem
finally. Jede Chromium-Instanz belegt zwischen 100 und 200 MB, und ein Browser, der nach einer Exception offen bleibt, legt am Ende den Worker lahm. - Das Binary gehört zum Deployment. Wir starten Chromium von einem Pfad, der per Umgebungsvariable festgelegt ist, und das Docker-Image installiert ihn. In einer Umgebung, der diese Variable fehlte, fiel eine Quelle mit
browserType.launch: Executable doesn't existaus, und im Code gab es keinen Fehler.
Ein eigener Browser löst nicht jede Sperre. Mehrere unserer Quellen geben jedem HTTP-Client 403 zurück, eine davon mit offener robots.txt. Hängt die Sperre von der IP oder vom Browser-Fingerprint ab, kommt auch ein Playwright nicht durch, das von einem Server im Rechenzentrum gestartet wird. Für diese Fälle integrieren wir Bright Data bei der betroffenen Quelle, ohne die anderen anzufassen.
Das Problem, das alle teilen: spanische Datumsangaben
Egal welche Strategie: Am Ende muss Text in Datumswerte umgewandelt werden. In unseren Quellen stehen „Del 10 al 28 de junio“, „Martes, 3 de marzo“, „jun 25“, „25.06“ und „25/06/2026“ nebeneinander.
Die Falle steckt im Date von JavaScript. In Node:
new Date('25 junio')  // Mon Jun 25 2001
new Date('jun 25')    // Mon Jun 25 2001
new Date('10')        // Mon Oct 01 2001
V8 erkennt „jun“ anhand der ersten drei Buchstaben als Juni und landet ohne Jahr bei 2001. Es wirft keinen Fehler: Die Veranstaltung wird mit einem Datum von vor 25 Jahren gespeichert und verschwindet aus allen Listen.
Die Regeln, die wir anwenden, in dieser Reihenfolge:
- Den Wochentag am Anfang entfernen („Martes, “).
- Die expliziten numerischen Formate probieren:
DD.MM.YYYY,DD.MM,DD/MM/YYYY. - Spanische Monatsnamen vor
new Date()probieren und das laufende Jahr verwenden, wenn keines angegeben ist. new Date()erst ganz am Schluss verwenden und einzelne Zahlen sowie jedes Jahr vor 2000 verwerfen.- Bei Zeiträumen wie „Del 10 al 28 de junio“ übernimmt der Anfang Monat und Jahr vom Ende.
Jedes ungewöhnliche Format, das in einer neuen Quelle auftaucht, wird zu einem Testfall.
Eine Schnittstelle, vier Implementierungen
Dass sich Strategien mischen lassen, ohne dass das System komplizierter wird, liegt daran, dass alle dasselbe zurückgeben:
interface SourceStrategy {
  fetch(source: Source): Promise<RawItem[]>;
}
Eine Registry löst die Strategie über den Schlüssel auf, der bei jeder Quelle gespeichert ist (api, rss, html-scraper, dynamic). Danach laufen alle Ergebnisse durch denselben Normalisierer (HTML entfernen, Leerzeichen bereinigen, Kategorien in Slugs umwandeln, ableiten, ob etwas kostenlos ist) und werden mit einem eindeutigen Schlüssel aus Quelle und externer ID gespeichert. Ein erneuter Lauf einer Quelle aktualisiert, was schon existiert, und dupliziert nichts.
Eine Quelle von HTML auf Headless-Browser umzustellen, oder von direkt auf Bright Data, heißt also, ihre Konfiguration zu ändern. Der Rest der Pipeline merkt davon nichts.
Checkliste für die Bestandsaufnahme einer Quelle
Vor dem ersten Code, für jede Website:
- Gibt es eine öffentliche API, ein Open-Data-Portal oder
/wp-json? - Welche Fetch/XHR-Anfragen schickt die Seite beim Laden?
- Hat sie RSS? Welches Datum steht darin?
- Steckt der Inhalt im HTML des Servers, oder rendert ihn JavaScript?
- Welche Felder stehen nur auf der Detailseite?
- Welche Datumsformate verwendet sie?
- Antwortet sie einem HTTP-Client mit 403? Und Playwright?
- Was steht in ihrer robots.txt und in ihren Nutzungsbedingungen?
Wenn Sie eine Liste von Quellen haben und wissen möchten, welche Strategie jede braucht: Genau mit diesem Steckbrief beginnt unser Web-Scraping-Service.