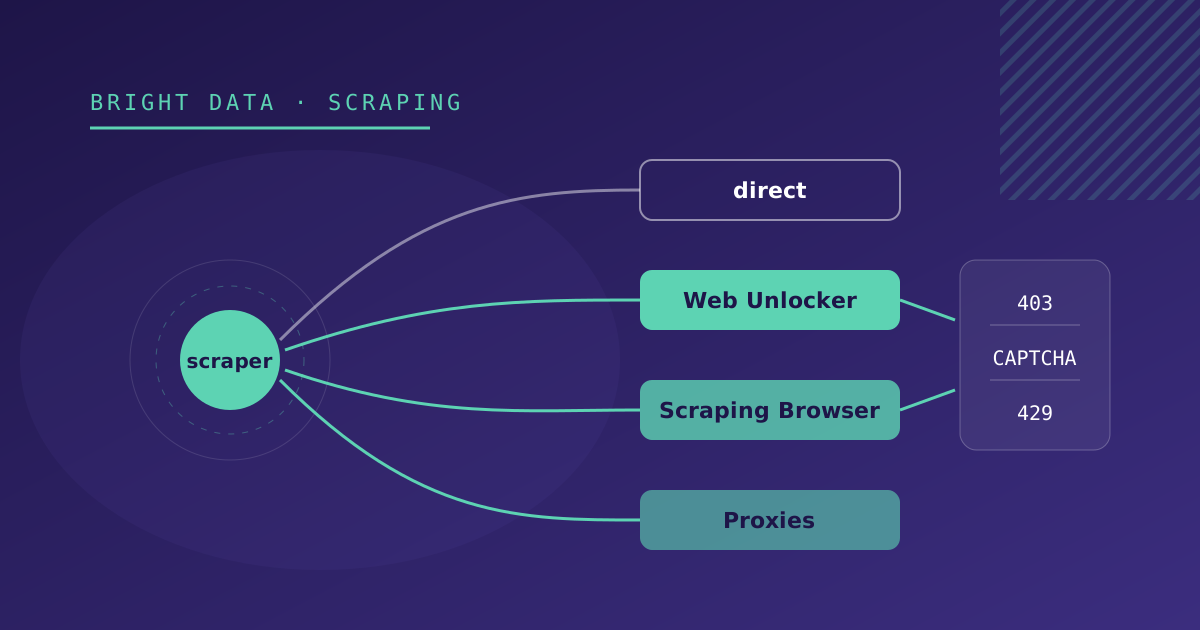
Drei Symptome führen zur selben Frage. Die Website gibt Ihrem Scraper 403 zurück. Oder sie antwortet mit einer Prüfseite statt mit dem Inhalt. Oder sie funktioniert ein paar Anfragen lang und antwortet dann mit 429 oder gar nicht mehr. Die Frage lautet, ob Sie einen Anbieter wie Bright Data bezahlen müssen.
Manchmal ja. Doch bevor Sie etwas buchen, sollten Sie die günstigen Ursachen ausschließen, denn ein Teil der Sperren lässt sich mit einer Zeile Code lösen. Und wenn es Bright Data braucht, sollten Sie es nur bei den Quellen aktivieren, die es brauchen.
Zuerst die günstigen Ursachen ausschließen
Der User-Agent. Axios meldet sich standardmäßig als axios/1.x, und viele Websites blockieren diesen User-Agent ohne weitere Prüfung. Die Header eines echten Browsers mitzuschicken (User-Agent, Accept, Accept-Language), entsperrt mehr Quellen, als man erwarten würde.
Das Tempo. Ein 429 ist die Bitte der Website, langsamer zu machen. Respektieren Sie den Header Retry-After, verteilen Sie die Anfragen und fragen Sie sich, ob Sie wirklich jede Stunde etwas abrufen müssen, das sich einmal am Tag ändert.
Ein eigener Headless-Browser. Wird der Inhalt mit JavaScript gerendert, reicht meist Playwright. Die Details stehen in So wählen Sie die Strategie für jede Quelle.
Gibt die Quelle danach immer noch 403 zurück, hängt die Sperre von etwas ab, das Sie von Ihrem Server aus nicht kontrollieren: der Reputation der IP Ihres Rechenzentrums, dem Browser-Fingerprint oder einem CAPTCHA. Hier kommt Bright Data ins Spiel.
Welches Produkt für welches Symptom
| Symptom | Bright-Data-Produkt | Warum |
|---|---|---|
| 403 oder Prüfseite, Inhalt steht im HTML | Web Unlocker | Löst CAPTCHAs, Fingerprint und Retries hinter einer einzigen Anfrage |
| Bot-Sperre auf einer Seite, die JavaScript oder Interaktion braucht | Scraping Browser | Remote-Browser mit eingebautem Unblocking; Ihr Playwright-Code bleibt gleich |
| 429 oder IP-Sperre nach ein paar Anfragen | Residential- oder ISP-Proxies | Verteilen die Anfragen auf IPs mit besserer Reputation |
| Inhalt unterscheidet sich je nach Land | Proxies mit festem Land | Die Anfrage geht von einer IP im benötigten Land aus |
| Ergebnisse von Google oder Bing | SERP API | Liefert die Ergebnisse bereits strukturiert als JSON |
| Große Domains (Marktplätze, Berufsprofile) | Web Scraper API oder Datasets | Bright Data pflegt den Extraktor bereits; Sie fragen die Daten ab |
Jedes Produkt wird im Bright-Data-Dashboard als „Zone“ mit eigenen Zugangsdaten gebucht und konfiguriert. So lassen sich mehrere in einem Projekt einsetzen, jedes bei den Quellen, die es brauchen.
Web Unlocker: der geringste Eingriff in Ihren Code
Web Unlocker lässt sich auf zwei Arten nutzen. Die einfachste ist als Proxy: Die Anfrage geht raus wie vorher, und Bright Data übernimmt unterwegs das Unblocking.
import axios from 'axios';
import { HttpsProxyAgent } from 'https-proxy-agent';

const { BRD_CUSTOMER, BRD_UNLOCKER_ZONE, BRD_UNLOCKER_PASSWORD } = process.env;

const agent = new HttpsProxyAgent(
  `http://brd-customer-${BRD_CUSTOMER}-zone-${BRD_UNLOCKER_ZONE}:${BRD_UNLOCKER_PASSWORD}@brd.superproxy.io:33335`,
);

const { data: html } = await axios.get(url, { httpsAgent: agent, proxy: false });
Da Bright Data die HTTPS-Verbindung abfängt, um sie zu entsperren, müssen Sie sein CA-Zertifikat im Client laden (zum Beispiel mit NODE_EXTRA_CA_CERTS). Die TLS-Prüfung abzuschalten, um schnell weiterzukommen, ist eine schlechte Idee: Das betrifft den ganzen Prozess, nicht nur diese Anfrage.
Die andere Art ist die REST API: ein POST an https://api.brightdata.com/request mit Zone und Ziel-URL, der das HTML zurückgibt. Das ist bequemer, wenn der Scraper in einer Umgebung läuft, in der sich ein Proxy nur umständlich konfigurieren lässt, etwa in manchen Serverless-Funktionen.
In beiden Fällen bleibt alles Weitere (cheerio, Selektoren, Normalisierung) gleich.
Scraping Browser: Ihr Playwright mit einem anderen Browser
Braucht die Quelle einen Browser, ersetzt Scraping Browser das Chromium, das Sie auf Ihrem Server starten, durch einen Remote-Browser in der Infrastruktur von Bright Data. Die Verbindung läuft über CDP:
import { chromium } from 'playwright';

const { BRD_CUSTOMER, BRD_BROWSER_ZONE, BRD_BROWSER_PASSWORD } = process.env;
const endpoint = `wss://brd-customer-${BRD_CUSTOMER}-zone-${BRD_BROWSER_ZONE}:${BRD_BROWSER_PASSWORD}@brd.superproxy.io:9222`;

const browser = await chromium.connectOverCDP(endpoint);
try {
  const page = await browser.newPage();
  await page.goto(url, { timeout: 120_000 });
  await page.waitForSelector('.agenda-item');
  // ...dieselbe Extraktion wie mit dem lokalen Browser
} finally {
  await browser.close();
}
Was sich gegenüber einem lokalen Browser ändert:
- Mehr Latenz. Der Browser ist weit weg und erledigt das Unblocking, bevor er Ihnen die Seite liefert. Erhöhen Sie die Navigations-Timeouts.
- Eine Session pro Quelle. Wir öffnen den Browser, extrahieren und schließen ihn. Lange offene Sessions verbrauchen Ressourcen und bringen nichts.
- Kein Binary mehr. Sie müssen Chromium nicht mehr ins Docker-Image installieren und seinen Pfad nicht in jeder Umgebung überwachen. Das ist eine der Ausfallursachen, die wir in So überwachen wir Scraper in Produktion dokumentiert haben.
Proxies: wenn die IP das Problem ist
Hat die Website keinen Bot-Schutz, limitiert aber nach IP oder zeigt je nach Land andere Inhalte, reichen Proxies. Bright Data bietet vier Typen:
- Datacenter: die günstigsten und schnellsten, aber mit IPs, die leicht als nicht-residential zu erkennen sind.
- ISP: Residential-IPs, die in Rechenzentren gehostet werden. Stabil und schnell; gut für lange Sessions.
- Residential: IPs echter Geräte. Am schwersten zu blockieren.
- Mobile: IPs von Mobilfunkanbietern, für die anspruchsvollsten Fälle.
Zwei Parameter werden im Benutzernamen des Proxys gesetzt:
-country-essorgt dafür, dass die Anfrage aus Spanien kommt.-session-<id>behält dieselbe IP über mehrere Anfragen bei, nützlich, wenn die Website Paginierung oder Cookies an die IP bindet.
Als weitere Strategie integrieren
Wenn wir Bright Data integrieren, wird der Transport zu einer Eigenschaft der Quelle, nicht des Codes. In der Konfiguration jeder Quelle:
{
  "strategy": "html-scraper",
  "transport": "unlocker",
  "listUrl": "https://ejemplo.com/agenda"
}
mit transport auf direct, unlocker, browser oder proxy. Der HTTP-Client oder der Browser wird aus diesem Feld gebaut, und der Rest der Pipeline weiß nicht, ob die Anfrage über Bright Data lief. Eine Quelle auf Bright Data umzustellen oder wieder direkt laufen zu lassen, heißt, ein Feld zu bearbeiten.
Die Zugangsdaten liegen in Umgebungsvariablen, eine Zone pro Produkt. Nie in der Konfiguration der Quelle, die meist in der Datenbank steht und von mehr Leuten gesehen wird.
Den Verbrauch kontrollieren
Bright Data rechnet nach Nutzung ab, und die Einheit hängt vom Produkt ab: Anfragen, übertragene GB oder Ergebnisse. Damit die Rechnung nicht überrascht:
- Messen Sie pro Quelle. Anfragen, Erfolgsquote und Volumen, gespeichert mit jedem Lauf. Eine Quelle, die plötzlich das Dreifache verbraucht, schlägt meist fehl und wiederholt ihre Anfragen.
- Rufen Sie keine Detailseiten ab, die Sie schon haben. Liefert die Liste eine stabile ID, besuchen Sie die Detailseite nur bei neuen Einträgen.
- Passen Sie die Frequenz an. Eine Quelle, die sich einmal am Tag ändert, muss nicht stündlich laufen.
- Prüfen Sie jeden Monat, welche Quellen wieder direkt laufen können. Websites wechseln den Anbieter ihres Bot-Schutzes und lockern ihn manchmal.
Was Bright Data nicht löst
Bright Data löst den technischen Zugang. Alles andere bleibt Ihre Arbeit:
- Redesigns. Ändert die Website ihre CSS-Klassen, schlägt der Selektor genauso fehl. Smoke-Tests bleiben nötig.
- Datumsangaben, Preise und Duplikate. Die Normalisierung ist mit und ohne Unblocking dieselbe.
- Die rechtlichen Grenzen. Nutzungsbedingungen, Rechte an Datenbanken und die DSGVO, wenn personenbezogene Daten betroffen sind, gelten genauso. Bright Data hat außerdem ein Verfahren zur Kundenprüfung und kann bestimmte Ziele oder Nutzungen einschränken.
Wenn Sie Quellen haben, die Ihnen 403 oder CAPTCHA zurückgeben: Auf unserer Seite zur Integration mit Bright Data erklären wir, wie wir das aufbauen, und beim Web-Scraping-Service, wie es zum Rest der Pipeline passt.