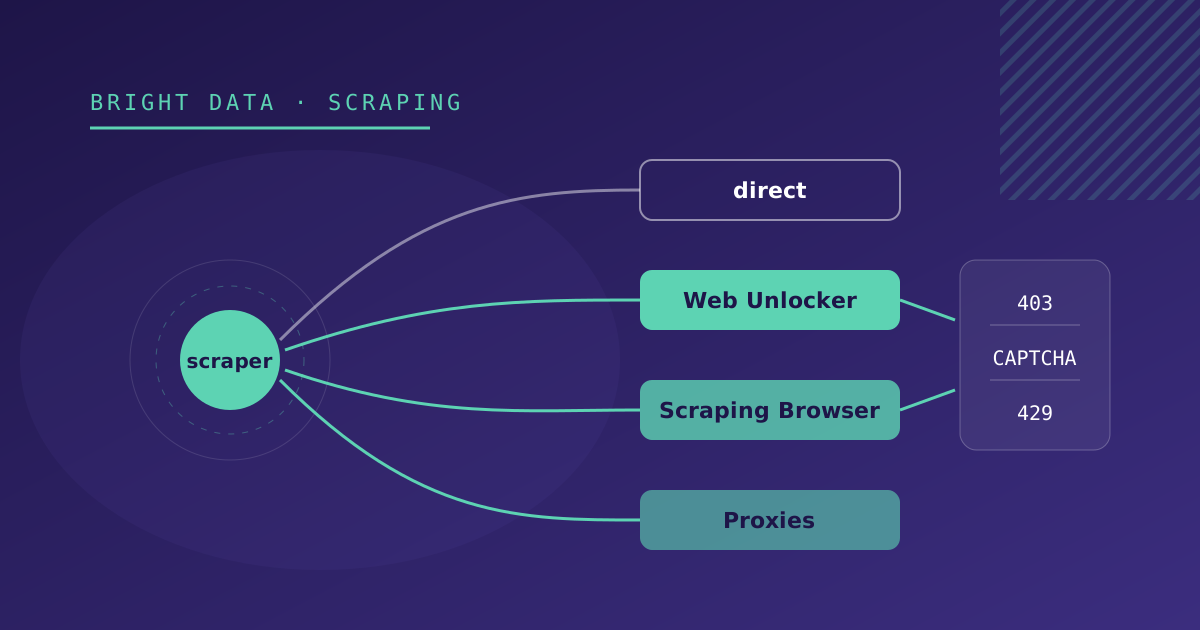
Hay tres síntomas que acaban en la misma pregunta. La web devuelve 403 a tu scraper. O responde con una página de verificación en vez del contenido. O funciona durante unas cuantas peticiones y después contesta 429 o deja de responder. La pregunta es si hace falta pagar a un proveedor como Bright Data.
A veces sí. Pero antes de contratar nada conviene descartar lo barato, porque una parte de los bloqueos se resuelve en una línea de código. Y cuando hace falta, conviene activarlo solo en las fuentes que lo necesitan.
Primero, descarta lo barato
El User-Agent. Axios se identifica por defecto como axios/1.x, y muchas webs bloquean ese User-Agent sin más análisis. Enviar las cabeceras de un navegador real (User-Agent, Accept, Accept-Language) desbloquea más fuentes de las que cabría esperar.
El ritmo. Un 429 es la web pidiéndote que vayas más despacio. Respeta la cabecera Retry-After, espacia las peticiones y pregúntate si de verdad necesitas consultar cada hora algo que cambia una vez al día.
Un navegador headless propio. Si el contenido lo pinta JavaScript, Playwright suele bastar. Lo contamos en detalle en cómo elegir la estrategia de cada fuente.
Si con eso la fuente sigue devolviendo 403, el bloqueo depende de algo que no controlas desde tu servidor: la reputación de la IP de tu centro de datos, la huella del navegador o un CAPTCHA. Ahí entra Bright Data.
Qué producto para cada síntoma
| Síntoma | Producto de Bright Data | Por qué |
|---|---|---|
| 403 o página de verificación, con el contenido en el HTML | Web Unlocker | Resuelve CAPTCHAs, huella y reintentos detrás de una sola petición |
| Bloqueo anti-bots en una página que necesita JavaScript o interacción | Scraping Browser | Navegador remoto con el desbloqueo incluido; tu código de Playwright no cambia |
| 429 o bloqueo por IP tras unas cuantas peticiones | Proxies residenciales o ISP | Reparten las peticiones entre IPs con mejor reputación |
| Contenido distinto según el país | Proxies con país fijado | La petición sale desde una IP del país que necesitas |
| Resultados de Google o Bing | SERP API | Devuelve los resultados ya estructurados en JSON |
| Dominios grandes (marketplaces, perfiles profesionales) | Web Scraper API o Datasets | Bright Data ya mantiene el extractor; tú pides los datos |
Cada uno se contrata y se configura como una «zona» en el panel de Bright Data, con sus propias credenciales. Eso permite usar varios en un mismo proyecto, cada uno en las fuentes que lo necesitan.
Web Unlocker: el que menos cambia tu código
Web Unlocker se puede usar de dos formas. La más sencilla es como un proxy: la petición sale igual que antes y Bright Data se encarga del desbloqueo por el camino.
import axios from 'axios';
import { HttpsProxyAgent } from 'https-proxy-agent';

const { BRD_CUSTOMER, BRD_UNLOCKER_ZONE, BRD_UNLOCKER_PASSWORD } = process.env;

const agent = new HttpsProxyAgent(
  `http://brd-customer-${BRD_CUSTOMER}-zone-${BRD_UNLOCKER_ZONE}:${BRD_UNLOCKER_PASSWORD}@brd.superproxy.io:33335`,
);

const { data: html } = await axios.get(url, { httpsAgent: agent, proxy: false });
Como Bright Data intercepta la conexión HTTPS para desbloquearla, hay que cargar su certificado CA en el cliente (por ejemplo con NODE_EXTRA_CA_CERTS). Desactivar la verificación TLS para salir del paso es mala idea: afecta a todo el proceso, no solo a esa petición.
La otra forma es su API REST: un POST a https://api.brightdata.com/request con la zona y la URL de destino, que devuelve el HTML. Es más cómoda si el scraper corre en un entorno donde configurar un proxy es incómodo, como algunas funciones serverless.
En los dos casos, lo que sigue (cheerio, selectores, normalización) no cambia.
Scraping Browser: tu Playwright, con otro navegador
Si la fuente necesita un navegador, Scraping Browser sustituye el Chromium que lanzas en tu servidor por uno remoto en la infraestructura de Bright Data. Te conectas por CDP:
import { chromium } from 'playwright';

const { BRD_CUSTOMER, BRD_BROWSER_ZONE, BRD_BROWSER_PASSWORD } = process.env;
const endpoint = `wss://brd-customer-${BRD_CUSTOMER}-zone-${BRD_BROWSER_ZONE}:${BRD_BROWSER_PASSWORD}@brd.superproxy.io:9222`;

const browser = await chromium.connectOverCDP(endpoint);
try {
  const page = await browser.newPage();
  await page.goto(url, { timeout: 120_000 });
  await page.waitForSelector('.agenda-item');
  // ...misma extracción que con el navegador local
} finally {
  await browser.close();
}
Lo que cambia respecto a un navegador local:
- Más latencia. El navegador está lejos y hace el desbloqueo antes de devolverte la página. Sube los timeouts de navegación.
- Una sesión por fuente. Abrimos el navegador, extraemos y cerramos. Mantener sesiones largas abiertas consume y no aporta.
- Te ahorras el binario. Ya no hay que instalar Chromium en la imagen Docker ni vigilar su ruta en cada entorno, que es una de las causas de caída que tenemos documentadas en cómo vigilamos los scrapers en producción.
Proxies: cuando el problema es la IP
Si la web no tiene protección anti-bots pero limita por IP, o muestra contenido distinto según el país, basta con proxies. Bright Data ofrece cuatro tipos:
- Datacenter: los más baratos y rápidos, pero con IPs fáciles de identificar como no residenciales.
- ISP: IPs residenciales alojadas en centros de datos. Estables y rápidas; buenas para sesiones largas.
- Residenciales: IPs de dispositivos reales. Las más difíciles de bloquear.
- Móviles: IPs de operadoras móviles, para los casos más exigentes.
Dos parámetros se fijan en el nombre de usuario del proxy:
-country-eshace que la petición salga desde España.-session-<id>mantiene la misma IP entre peticiones, útil cuando la web asocia la paginación o las cookies a la IP.
Integrarlo como una estrategia más
Cuando integramos Bright Data, el transporte pasa a ser una propiedad de la fuente, no del código. En la configuración de cada fuente:
{
  "strategy": "html-scraper",
  "transport": "unlocker",
  "listUrl": "https://ejemplo.com/agenda"
}
con transport a direct, unlocker, browser o proxy. El cliente HTTP o el navegador se construyen a partir de ese campo, y el resto del pipeline no sabe si la petición ha pasado por Bright Data. Pasar una fuente a Bright Data, o devolverla a salida directa, es editar un campo.
Las credenciales van en variables de entorno, una zona por producto. Nunca en la configuración de la fuente, que suele estar en la base de datos y la ve más gente.
Controlar el consumo
Bright Data cobra por uso, y la unidad depende del producto: peticiones, GB transferidos o resultados. Para que la factura no sorprenda:
- Mide por fuente. Peticiones, tasa de éxito y volumen, guardados con cada ejecución. Una fuente que de repente consume el triple suele estar fallando y reintentando.
- No pidas fichas que ya tienes. Si el listado trae un identificador estable, visita la ficha de detalle solo de los elementos nuevos.
- Ajusta la frecuencia. La fuente que cambia una vez al día no necesita ejecutarse cada hora.
- Revisa cada mes qué fuentes pueden volver a directo. Las webs cambian de proveedor de protección, y a veces lo relajan.
Lo que Bright Data no resuelve
Bright Data resuelve el acceso técnico. Todo lo demás sigue siendo trabajo tuyo:
- Los rediseños. Si la web cambia sus clases CSS, el selector falla igual. Los smoke tests siguen haciendo falta.
- Las fechas, los precios y los duplicados. La normalización es la misma con o sin desbloqueo.
- Los límites legales. Términos de uso, derechos sobre bases de datos y RGPD si hay datos personales se aplican igual. Bright Data tiene además un proceso de verificación de clientes y puede restringir ciertos destinos o usos.
Si tienes fuentes que te devuelven 403 o CAPTCHA, en nuestra página de integración con Bright Data explicamos cómo lo montamos, y en el servicio de web scraping cómo encaja con el resto del pipeline.