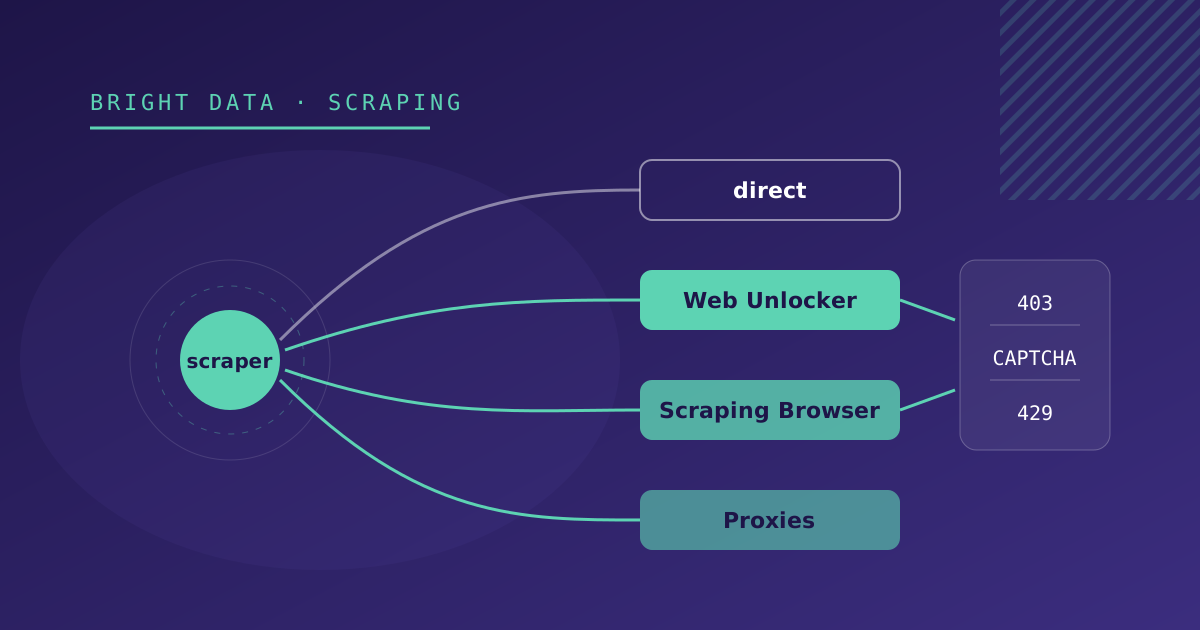
Ci sono tre sintomi che portano alla stessa domanda. Il sito restituisce 403 al tuo scraper. Oppure risponde con una pagina di verifica invece del contenuto. Oppure funziona per qualche richiesta e poi risponde 429 o smette di rispondere. La domanda è se serve pagare un fornitore come Bright Data.
A volte sì. Ma prima di sottoscrivere qualcosa conviene escludere le soluzioni economiche, perché una parte dei blocchi si risolve con una riga di codice. E quando serve, conviene attivarlo solo sulle fonti che ne hanno bisogno.
Prima di tutto, escludi le soluzioni economiche
Lo User-Agent. Axios si identifica di default come axios/1.x, e molti siti bloccano quello User-Agent senza ulteriori analisi. Inviare gli header di un browser reale (User-Agent, Accept, Accept-Language) sblocca più fonti di quanto ci si aspetterebbe.
Il ritmo. Un 429 è il sito che ti chiede di andare più piano. Rispetta l’header Retry-After, distanzia le richieste e chiediti se ti serve davvero interrogare ogni ora qualcosa che cambia una volta al giorno.
Un browser headless proprio. Se il contenuto lo disegna JavaScript, di solito basta Playwright. Lo spieghiamo nel dettaglio in come scegliere la strategia per ogni fonte.
Se dopo tutto questo la fonte restituisce ancora 403, il blocco dipende da qualcosa che non controlli dal tuo server: la reputazione dell’IP del tuo datacenter, l’impronta del browser o un CAPTCHA. Qui entra in gioco Bright Data.
Quale prodotto per ogni sintomo
| Sintomo | Prodotto Bright Data | Perché |
|---|---|---|
| 403 o pagina di verifica, con il contenuto nell’HTML | Web Unlocker | Risolve CAPTCHA, impronta e retry dietro un’unica richiesta |
| Blocco anti-bot su una pagina che richiede JavaScript o interazione | Scraping Browser | Browser remoto con lo sblocco incluso; il tuo codice Playwright non cambia |
| 429 o blocco per IP dopo qualche richiesta | Proxy residenziali o ISP | Distribuiscono le richieste tra IP con una reputazione migliore |
| Contenuto diverso in base al paese | Proxy con paese fissato | La richiesta parte da un IP del paese che ti serve |
| Risultati di Google o Bing | SERP API | Restituisce i risultati già strutturati in JSON |
| Grandi domini (marketplace, profili professionali) | Web Scraper API o Datasets | Bright Data mantiene già l’estrattore; tu chiedi i dati |
Ognuno si attiva e si configura come una «zona» nel pannello di Bright Data, con le proprie credenziali. Questo permette di usarne diversi nello stesso progetto, ciascuno sulle fonti che ne hanno bisogno.
Web Unlocker: quello che cambia meno il tuo codice
Web Unlocker si può usare in due modi. Il più semplice è come proxy: la richiesta parte come prima e Bright Data si occupa dello sblocco lungo il percorso.
import axios from 'axios';
import { HttpsProxyAgent } from 'https-proxy-agent';

const { BRD_CUSTOMER, BRD_UNLOCKER_ZONE, BRD_UNLOCKER_PASSWORD } = process.env;

const agent = new HttpsProxyAgent(
  `http://brd-customer-${BRD_CUSTOMER}-zone-${BRD_UNLOCKER_ZONE}:${BRD_UNLOCKER_PASSWORD}@brd.superproxy.io:33335`,
);

const { data: html } = await axios.get(url, { httpsAgent: agent, proxy: false });
Siccome Bright Data intercetta la connessione HTTPS per sbloccarla, bisogna caricare il suo certificato CA nel client (per esempio con NODE_EXTRA_CA_CERTS). Disattivare la verifica TLS per cavarsela è una cattiva idea: riguarda tutto il processo, non solo quella richiesta.
L’altro modo è la sua API REST: un POST a https://api.brightdata.com/request con la zona e l’URL di destinazione, che restituisce l’HTML. È più comoda se lo scraper gira in un ambiente dove configurare un proxy è scomodo, come alcune funzioni serverless.
In entrambi i casi, ciò che segue (cheerio, selettori, normalizzazione) non cambia.
Scraping Browser: il tuo Playwright, con un altro browser
Se la fonte richiede un browser, Scraping Browser sostituisce il Chromium che lanci sul tuo server con uno remoto sull’infrastruttura di Bright Data. Ti colleghi via CDP:
import { chromium } from 'playwright';

const { BRD_CUSTOMER, BRD_BROWSER_ZONE, BRD_BROWSER_PASSWORD } = process.env;
const endpoint = `wss://brd-customer-${BRD_CUSTOMER}-zone-${BRD_BROWSER_ZONE}:${BRD_BROWSER_PASSWORD}@brd.superproxy.io:9222`;

const browser = await chromium.connectOverCDP(endpoint);
try {
  const page = await browser.newPage();
  await page.goto(url, { timeout: 120_000 });
  await page.waitForSelector('.agenda-item');
  // ...stessa estrazione del browser locale
} finally {
  await browser.close();
}
Cosa cambia rispetto a un browser locale:
- Più latenza. Il browser è lontano e fa lo sblocco prima di restituirti la pagina. Alza i timeout di navigazione.
- Una sessione per fonte. Apriamo il browser, estraiamo e chiudiamo. Tenere aperte sessioni lunghe consuma e non porta nulla.
- Ti risparmi il binario. Non serve più installare Chromium nell’immagine Docker né controllarne il percorso in ogni ambiente, che è una delle cause di guasto documentate in come monitoriamo gli scraper in produzione.
Proxy: quando il problema è l’IP
Se il sito non ha protezione anti-bot ma limita per IP, o mostra contenuti diversi in base al paese, bastano i proxy. Bright Data ne offre quattro tipi:
- Datacenter: i più economici e veloci, ma con IP facili da riconoscere come non residenziali.
- ISP: IP residenziali ospitati in datacenter. Stabili e veloci; adatti alle sessioni lunghe.
- Residenziali: IP di dispositivi reali. I più difficili da bloccare.
- Mobili: IP di operatori mobili, per i casi più esigenti.
Due parametri si impostano nel nome utente del proxy:
-country-esfa partire la richiesta dalla Spagna.-session-<id>mantiene lo stesso IP tra le richieste, utile quando il sito associa la paginazione o i cookie all’IP.
Integrarlo come una strategia in più
Quando integriamo Bright Data, il trasporto diventa una proprietà della fonte, non del codice. Nella configurazione di ogni fonte:
{
  "strategy": "html-scraper",
  "transport": "unlocker",
  "listUrl": "https://ejemplo.com/agenda"
}
con transport impostato a direct, unlocker, browser o proxy. Il client HTTP o il browser vengono costruiti a partire da quel campo, e il resto della pipeline non sa se la richiesta è passata da Bright Data. Spostare una fonte su Bright Data, o riportarla all’uscita diretta, significa modificare un campo.
Le credenziali vanno in variabili d’ambiente, una zona per prodotto. Mai nella configurazione della fonte, che di solito sta nel database e la vedono più persone.
Tenere sotto controllo i consumi
Bright Data fa pagare a consumo, e l’unità dipende dal prodotto: richieste, GB trasferiti o risultati. Perché la fattura non sorprenda:
- Misura per fonte. Richieste, tasso di successo e volume, salvati con ogni esecuzione. Una fonte che all’improvviso consuma il triplo di solito sta fallendo e ritentando.
- Non chiedere schede che hai già. Se l’elenco porta un identificativo stabile, visita la scheda di dettaglio solo per gli elementi nuovi.
- Regola la frequenza. La fonte che cambia una volta al giorno non ha bisogno di girare ogni ora.
- Controlla ogni mese quali fonti possono tornare dirette. I siti cambiano fornitore di protezione, e a volte la allentano.
Cosa Bright Data non risolve
Bright Data risolve l’accesso tecnico. Tutto il resto rimane lavoro tuo:
- I redesign. Se il sito cambia le sue classi CSS, il selettore fallisce comunque. Gli smoke test servono ancora.
- Date, prezzi e duplicati. La normalizzazione è la stessa con o senza sblocco.
- I limiti legali. Termini d’uso, diritti sulle banche dati e GDPR in presenza di dati personali si applicano allo stesso modo. Bright Data ha inoltre un processo di verifica dei clienti e può limitare certe destinazioni o usi.
Se hai fonti che ti restituiscono 403 o CAPTCHA, nella nostra pagina di integrazione con Bright Data spieghiamo come la impostiamo, e nel servizio di web scraping come si inserisce nel resto della pipeline.