En nueve meses de 2026 la IA ha pasado de encontrar en la bibliografía soluciones olvidadas a problemas de Erdős a que OpenAI publique lo que presenta como una prueba completa de Navier-Stokes, uno de los siete problemas del milenio. Por el camino, un medallista Fields ha dejado la universidad para irse a OpenAI, un matemático de Princeton ha dejado de trabajar en problemas de Erdős porque “ya no tiene sentido”, y el responsable del mayor catálogo de esos problemas ha admitido que hay pruebas que ningún humano va a leer.
Nosotros no vamos a resolver la hipótesis de Riemann. Pero el método con el que se están consiguiendo estos resultados es el mismo que separa un agente de IA que funciona en producción de uno que se queda en demo, y casi nadie lo está contando desde ese lado. Este artículo repasa qué ha pasado, por qué ha funcionado y qué se puede copiar en el software de una empresa.
Lo que ha pasado en 2026, en orden
| Fecha | Quién | Qué | Estado |
|---|---|---|---|
| 25 dic 2025 | Kevin Barreto (estudiante de Cambridge) | Publica una prueba generada con IA del problema de Erdős 333 | Retirada en horas: Erdős ya lo había resuelto en un artículo de 1977 |
| 4 ene 2026 | Barreto, con GPT-5.2 Pro y Aristotle (Harmonic) | Resuelve el problema de Erdős 728 y certifica la prueba en Lean | Publicada en arXiv |
| 28 feb 2026 | Donald Knuth | Publica “Claude’s Cycles”: Claude Opus 4.6 encuentra una construcción para un problema de ciclos hamiltonianos que Knuth tenía abierto | Knuth escribe la demostración a mano |
| 20 may 2026 | OpenAI (modelo interno) | Contraejemplo a la conjetura de Erdős sobre distancias unitarias, de 1946 | Revisado por matemáticos externos; humanos lo mejoraron en semanas |
| mayo 2026 | Google DeepMind | Su mejor agente resuelve 9 de 353 problemas de Erdős formalizados | Paper con 21 autores |
| 1-2 ago 2026 | OpenAI | Anuncia el modelo Astra con 10 resultados nuevos y sus certificados en Lean 4 | Sin revisión por pares |
| 8 sep 2026 | OpenAI | Publica una prueba de existencia y suavidad de Navier-Stokes | En revisión y con disputa de autoría |
| 22 sep 2026 | OpenAI | Dice que un modelo interno ha resuelto más de 100 problemas abiertos | Publica cientos de manuscritos a principios de octubre |
La tabla mezcla dos cosas distintas, y conviene separarlas. Los problemas de Erdős son cientos de preguntas de dificultad muy desigual, muchas de las cuales casi nadie había mirado en serio. Navier-Stokes es un problema que ha resistido a los mejores matemáticos durante décadas. Que caigan los primeros dice mucho del método. Que caiga el segundo, si se confirma, dice algo de la capacidad bruta de los modelos. Para una empresa interesa sobre todo lo primero.
Por qué caen los problemas de Erdős y no otros
Paul Erdős dejó más de mil artículos y una costumbre: plantear problemas, a veces con una recompensa en dólares. Thomas Bloom, hoy en la Universidad de Manchester, empezó a recopilarlos en erdosproblems.com a principios de 2023 con un par de cientos. En agosto de 2025 eran casi mil. Según Quanta Magazine, en agosto de 2026 la base de datos tenía 565 resueltos y 652 abiertos.
Quanta da tres razones para que la IA avance aquí y no en otras áreas:
- El terreno: los problemas están sobre todo en teoría de números, combinatoria y teoría de grafos, las áreas donde los modelos de lenguaje han resultado más capaces.
- La dificultad desigual: hay problemas triviales para un especialista y otros que nadie ha tocado. Una tecnología cuyas capacidades también son desiguales encuentra siempre alguno a su alcance.
- El catálogo público: un repositorio único, ordenado y accesible es un banco de pruebas gratis. Jared Duker Lichtman, de Stanford, lo resume así: “los laboratorios se dieron cuenta de que esto podía funcionar como benchmark”.
Hay una cuarta razón menos vistosa. Una parte de los problemas “abiertos” no lo estaban: la solución estaba publicada y nadie la había conectado con la pregunta. El caso del problema 333 es el ejemplo extremo. Barreto publicó una prueba generada con IA la mañana de Navidad y unas horas después otro usuario enlazó el artículo de 1977 donde Erdős ya lo había resuelto. Su conclusión, dirigida a la comunidad, fue pedir “más atención a la búsqueda bibliográfica”.
Un detalle de quién hace este trabajo: Barreto es estudiante de grado. Liam Price, con quien lo hace, dejó la universidad sin terminar. Wouter van Doorn trabaja en atención al cliente. Price reconoce, según Quanta, que no tiene la formación para verificar él mismo las pruebas que saca de los modelos. Lo que sí tiene es un procedimiento.
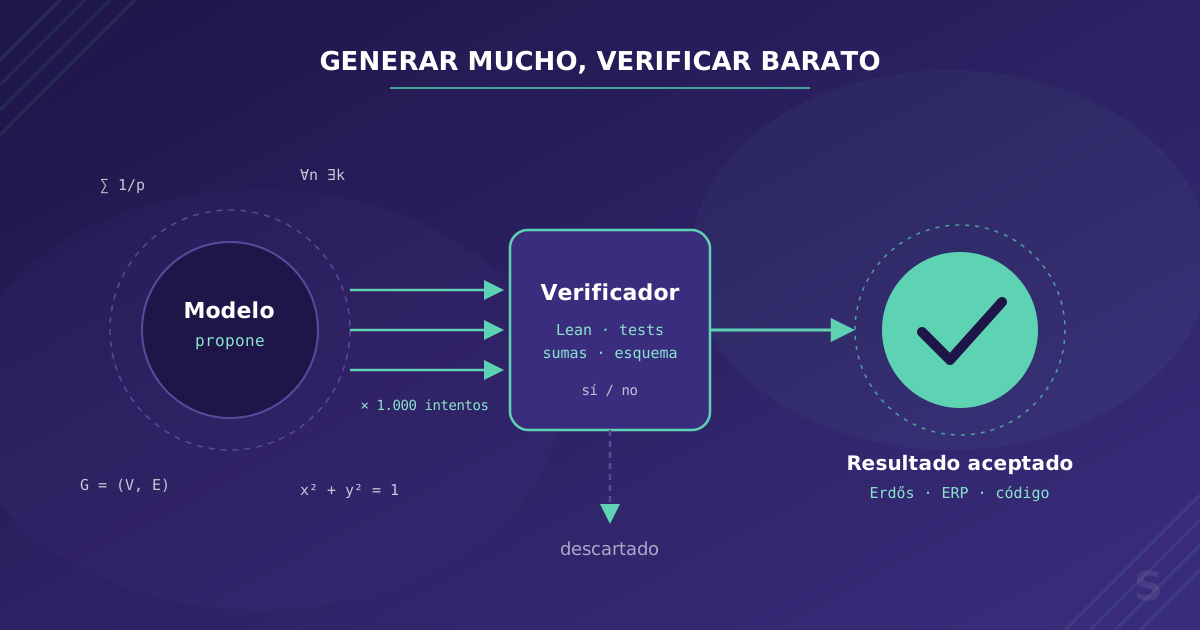
El patrón que se repite: generar mucho, verificar barato
El procedimiento de Price consiste en pedir una solución a un chatbot, pasársela a una instancia nueva para que la revise y repetir. David Woodruff, de Carnegie Mellon, describe el mismo principio en el trabajo que hizo con Google sobre un problema de ondas gravitacionales: “si lo llamo muchas veces, quizá una de ellas acierte”. En su sistema el modelo propone hipótesis, un verificador automático comprueba las matemáticas y un investigador hace la revisión final.
En los resultados más sólidos de la lista, el verificador es Lean, un asistente de pruebas en el que cada paso de una demostración se comprueba mecánicamente. OpenAI publicó los diez resultados de Astra con certificados en Lean 4 y cero sorry, la palabra con la que Lean marca un paso que se da por bueno sin demostrarlo. Con eso nadie tiene que fiarse del modelo: si Lean compila la prueba, la prueba es correcta respecto al enunciado formalizado.
La nota de Knuth sigue el mismo esquema, con humanos en el papel de verificador. Claude Opus 4.6 encontró una construcción para descomponer un grafo dirigido en tres ciclos hamiltonianos cuando el parámetro es impar. Filip Stappers la probó por ordenador para todos los valores impares hasta 101, y después Knuth escribió la demostración general.
Las tres historias comparten estructura:
- El modelo no es de fiar y nadie lo trata como si lo fuera.
- Hay un verificador independiente que dice sí o no sin interpretar: Lean, un programa que prueba cien casos, otra instancia del modelo con instrucciones de buscar fallos.
- Como verificar es barato, se pueden generar muchas propuestas y quedarse con las que pasan.
Esa es la parte que se puede llevar a una empresa. La capacidad matemática de Astra no está disponible, y para la mayoría de problemas de negocio tampoco hace falta.
Dónde está el “Lean” de tu empresa
La pregunta útil ante cualquier proceso que se quiera automatizar con IA es qué hace de verificador. Si existe y es barato, el modelo puede equivocarse nueve de cada diez veces y el sistema funciona igual. Si no existe, cada error llega al cliente.
| Problema | Verificador barato | Qué hace el modelo |
|---|---|---|
| Migrar datos de un ERP antiguo | Recuentos por tabla, sumas de importes, claves foráneas que resuelven | Escribe y corrige los scripts de transformación hasta que cuadra |
| Modernizar código heredado | La suite de tests existente, el compilador, el tipado | Propone el cambio; si rompe un test, se descarta |
| Extraer datos de facturas o albaranes | Validación contra esquema, base + IVA = total, NIF con dígito de control | Lee el documento; lo que no cuadra va a revisión humana |
| Generar consultas SQL desde lenguaje natural | Ejecutar contra una réplica y comparar con resultados conocidos | Propone la consulta |
| Planificar turnos o rutas | Restricciones duras (horas máximas, ventanas de entrega) y una función de coste | Propone planes o, mejor, heurísticas que los generan |
| Redactar respuestas de soporte | Débil: rúbrica evaluada por otro modelo y muestreo humano | Redacta |
La última fila está ahí a propósito. Hay tareas sin un verificador mecánico, y en ellas la técnica de Price (otra instancia que revisa) es lo mejor que hay. Lo explicamos en detalle en LLM como juez: funciona, pero hay que calibrarlo contra juicio humano y vigilar sus sesgos. Cuanto más arriba en la tabla, más se parece el problema a un problema de Erdős, y mejor resultado da la IA.
Para cualquier proceso de la columna izquierda, la regla práctica es escribir el verificador antes que el prompt. Un equipo que empieza por el prompt acaba ajustándolo a ojo con cinco ejemplos. Uno que empieza por el verificador puede probar cuatro modelos y diez variantes de prompt en una tarde y quedarse con la que más casos pasa.
AlphaEvolve: cuando el verificador es una función de coste
Hay una variante del patrón que sirve para problemas de optimización, donde no hay una respuesta correcta sino respuestas mejores y peores. Google DeepMind la presentó en mayo de 2025 con AlphaEvolve: un agente que escribe programas, los ejecuta contra un evaluador que les pone nota y hace evolucionar los que puntúan mejor.
En matemáticas, el equipo lo aplicó después a 67 problemas, igualó la mayoría de las construcciones conocidas y mejoró varias, con la participación de Terence Tao y Javier Gómez-Serrano. Pero el primer resultado que publicó DeepMind no era matemático: una heurística de planificación para los centros de datos de Google que, según la compañía, recupera de media un 0,7% de su capacidad de cómputo mundial.
Lo interesante para una empresa es la forma del resultado. AlphaEvolve no decide cada asignación. Escribe un programa corto y legible que las decide, y ese programa se revisa, se despliega y se mantiene como cualquier otro. En procesos como el reparto de rutas, la asignación de turnos o la reposición de stock pasa igual: si hay datos históricos para reproducir semanas pasadas y una métrica que diga qué plan es mejor, se puede montar un bucle de este tipo sin tocar el sistema de producción hasta tener un ganador.
La lista larga de problemas que nadie mira
Antes de la IA, la mayoría de problemas de Erdős no estaban abiertos por difíciles. Estaban abiertos porque no le compensaban a nadie: un especialista podía resolver muchos en una semana, pero tenía cosas más importantes que hacer. Noga Alon, de Princeton, lo dijo en Quanta al explicar por qué ha dejado de trabajar en ellos: “una vez que la IA empezó a resolverlos, ya no tiene sentido”.
Toda empresa tiene su propia lista de problemas de Erdős. La integración que se hace a mano cada lunes con una hoja de cálculo. Los 2.000 productos con la descripción vacía. El informe que alguien rehace cada trimestre copiando de tres sitios. El script de 2014 que nadie se atreve a tocar. Ninguno justifica un proyecto, y por eso llevan años en el backlog.
El coste por problema es lo que ha cambiado. El agente de DeepMind resolvía cada problema de Erdős por unos cientos de dólares. Los diez resultados de Astra costaron, según SiliconANGLE, unos 2.000 dólares a precio de API. En el otro extremo, TechCrunch calcula que la prueba de Navier-Stokes consumió 300.000 millones de tokens de salida, unos 22,5 millones de dólares a la tarifa de Astra. El coste crece con la dificultad, y la mayoría de lo que hay en un backlog está en el extremo barato. Los números de cada modelo los desglosamos en lo que cuesta ejecutar LLMs en producción.
Para ordenar esa lista vale el mismo criterio que con los problemas matemáticos: primero los que tienen verificador barato y poco valor individual, porque son los que nadie iba a atacar a mano y donde un error se detecta antes de causar daño.
Antes de resolver, busca
El problema 333 deja una lección más prosaica. Una parte importante de lo que se celebró como “la IA resuelve un problema abierto” fue la IA encontrando una solución que ya estaba publicada. Bloom lo dijo en octubre de 2025, cuando OpenAI afirmó que GPT-5 había resuelto diez problemas de Erdős: eran hallazgos bibliográficos.
Eso tiene valor, y en una empresa es el caso de uso más frecuente. La respuesta a la pregunta del cliente suele estar en un PDF de 2019, en un hilo de correo o en la cabeza de alguien que se jubila el año que viene. Un sistema que la encuentra y la cita ahorra más horas que uno que razona desde cero, y se equivoca menos. Pero solo funciona si el conocimiento está en un sitio donde se pueda buscar, que es de lo que va preparar una base de conocimiento para IA.
El orden práctico es buscar primero, razonar después y marcar siempre cuál de las dos cosas ha hecho el sistema. Una respuesta citada se verifica abriendo la fuente. Una razonada necesita otro verificador.
El cuello de botella pasa a la revisión
Thomas Bloom, en Quanta, sobre una de las pruebas generadas: “Pero ningún humano la ha leído, y ningún humano la va a leer. Ahora es un reto enorme”. A principios de octubre OpenAI publicó cientos de manuscritos de golpe, y parte de la comunidad matemática respondió pidiendo un boicot. Generar dejó de ser lo caro. Revisar sigue costando lo mismo que antes.
En una empresa pasa igual, a otra escala. Un agente que abre cuarenta pull requests al día o que propone doscientas fichas de producto por hora no acelera nada si el equipo puede revisar diez. Los cambios se acumulan, la revisión se vuelve superficial y los errores pasan.
Lo que funciona es repartir la revisión por capas:
- Verificación automática de todo lo que se pueda comprobar mecánicamente. Lo que no pasa no llega a ninguna persona.
- Evaluación por otro modelo con una rúbrica para lo que queda, que ordena por riesgo.
- Revisión humana de lo que el evaluador marca como dudoso y de una muestra aleatoria del resto, para detectar si el evaluador se ha desviado.
Con la prueba de Navier-Stokes ni siquiera eso basta, porque el resultado es nuevo y nadie tiene con qué compararlo. NPR lo resumió en un titular: la IA resolvió uno de los problemas más difíciles de las matemáticas y la humanidad no aprendió nada (de momento). En un proceso de negocio el equivalente es aceptar un cambio que funciona sin que nadie del equipo entienda por qué. Para código que alguien tendrá que mantener, eso es una deuda.
Datos y autoría: lo que enseña la disputa de Navier-Stokes
El mismo día del anuncio, TechCrunch publicó la versión de Tristan Buckmaster, matemático de NYU que trabajaba en el problema junto a Levent Alpöge, de Anthropic. Buckmaster sostiene que Sébastien Bubeck, de OpenAI, le pidió retirar el crédito a Alpöge. Buckmaster había usado Codex, la herramienta de programación de OpenAI, durante su trabajo. Según TechCrunch, la publicación de OpenAI dice: “aunque es poco probable, no podemos descartar que datos desidentificados derivados de su uso de nuestros productos hayan ayudado a mejorar nuestros modelos”.
Sea cual sea el desenlace, la frase vale para cualquier empresa que meta su código, sus contratos o sus datos de clientes en una herramienta de IA. Antes de hacerlo hay que saber si el plan contratado excluye el entrenamiento con tus datos, qué se retiene y durante cuánto tiempo, y dónde se procesa. Los planes empresariales de los principales proveedores lo permiten; los gratuitos y algunos de pago individuales, no siempre. Es una casilla en un contrato, y conviene marcarla antes del primer prompt.
Cómo saber si tu problema tiene “forma de Erdős”
Cinco preguntas para decidir si un proceso es buen candidato para resolverlo con IA, en el orden en que las hacemos:
- ¿Hay un verificador barato? Un test, una suma que tiene que cuadrar, un esquema, una restricción. Si la única forma de saber si el resultado está bien es que lo mire un experto, la IA sirve de borrador, no de sistema.
- ¿Se pueden generar muchos intentos? Si cada intento tiene efectos en el mundo real (un correo enviado, un pedido lanzado), primero hay que montar un entorno donde no los tenga.
- ¿Está ya resuelto en algún sitio? En la documentación interna, en el histórico de tickets, en la librería que ya existe. Buscar es más barato que razonar.
- ¿Quién va a revisar el volumen que salga? Si la respuesta es “el mismo equipo que ahora no da abasto”, el diseño de la revisión es parte del proyecto.
- ¿Puedes poner tus datos en la herramienta? Revisa las condiciones de uso antes de la prueba de concepto, no después.
Un proceso que responde bien a las tres primeras se parece más a un problema de Erdős que a Navier-Stokes, y suele salir en semanas.
Lo que hacemos nosotros con esto
En los proyectos de agentes de IA tratamos la evaluación como una especialidad aparte: antes de elegir modelo o escribir prompts, definimos qué cuenta como resultado correcto y cómo se comprueba de forma automática. Con eso se pueden comparar modelos con datos y no con impresiones, y se sabe si un cambio de versión del proveedor ha empeorado algo antes de que lo note un cliente.
Si tienes en el backlog una lista de tareas que nadie ataca porque no compensan, cuéntanos tres. Te diremos cuáles tienen verificador, cuáles necesitan construirlo y cuáles conviene dejar en manos de una persona. Puedes escribirnos desde la página de inteligencia artificial.