Em nove meses de 2026, a IA passou de encontrar na bibliografia soluções esquecidas para problemas de Erdős a ver a OpenAI publicar aquilo que apresenta como uma prova completa de Navier-Stokes, um dos sete problemas do milénio. Pelo caminho, um medalhista Fields trocou a universidade pela OpenAI, um matemático de Princeton deixou de trabalhar em problemas de Erdős porque “já não faz sentido”, e o responsável pelo maior catálogo desses problemas admitiu que há provas que nenhum humano vai ler.
Nós não vamos resolver a hipótese de Riemann. Mas o método com que estes resultados estão a ser obtidos é o mesmo que separa um agente de IA que funciona em produção de um que fica pela demo, e quase ninguém está a contar a história desse lado. Este texto revê o que aconteceu, porque funcionou e o que se pode copiar para o software de uma empresa.
O que aconteceu em 2026, por ordem
| Data | Quem | O quê | Estado |
|---|---|---|---|
| 25 dez 2025 | Kevin Barreto (estudante de Cambridge) | Publica uma prova gerada com IA do problema de Erdős 333 | Retirada em poucas horas: Erdős já o tinha resolvido num artigo de 1977 |
| 4 jan 2026 | Barreto, com GPT-5.2 Pro e Aristotle (Harmonic) | Resolve o problema de Erdős 728 e certifica a prova em Lean | Publicada no arXiv |
| 28 fev 2026 | Donald Knuth | Publica “Claude’s Cycles”: o Claude Opus 4.6 encontra uma construção para um problema de ciclos hamiltonianos que Knuth tinha em aberto | Knuth escreve a demonstração à mão |
| 20 mai 2026 | OpenAI (modelo interno) | Contraexemplo à conjetura de Erdős sobre distâncias unitárias, de 1946 | Revisto por matemáticos externos; humanos melhoraram-no em semanas |
| maio 2026 | Google DeepMind | O seu melhor agente resolve 9 de 353 problemas de Erdős formalizados | Artigo com 21 autores |
| 1-2 ago 2026 | OpenAI | Anuncia o modelo Astra com 10 resultados novos e os respetivos certificados em Lean 4 | Sem revisão por pares |
| 8 set 2026 | OpenAI | Publica uma prova de existência e suavidade de Navier-Stokes | Em revisão e com disputa de autoria |
| 22 set 2026 | OpenAI | Diz que um modelo interno resolveu mais de 100 problemas em aberto | Publica centenas de manuscritos no início de outubro |
A tabela mistura duas coisas distintas, e convém separá-las. Os problemas de Erdős são centenas de perguntas de dificuldade muito desigual, muitas das quais quase ninguém tinha olhado a sério. Navier-Stokes é um problema que resistiu aos melhores matemáticos durante décadas. Que caiam os primeiros diz muito sobre o método. Que caia o segundo, se se confirmar, diz algo sobre a capacidade bruta dos modelos. Para uma empresa, interessa sobretudo o primeiro.
Porque caem os problemas de Erdős e não outros
Paul Erdős deixou mais de mil artigos e um hábito: propor problemas, por vezes com uma recompensa em dólares. Thomas Bloom, hoje na Universidade de Manchester, começou a compilá-los em erdosproblems.com no início de 2023, com umas duas centenas. Em agosto de 2025 eram quase mil. Segundo a Quanta Magazine, em agosto de 2026 a base de dados tinha 565 resolvidos e 652 em aberto.
A Quanta aponta três razões para a IA avançar aqui e não noutras áreas:
- O terreno: os problemas estão sobretudo em teoria dos números, combinatória e teoria dos grafos, as áreas onde os modelos de linguagem se revelaram mais capazes.
- A dificuldade desigual: há problemas triviais para um especialista e outros em que ninguém tocou. Uma tecnologia com capacidades igualmente desiguais encontra sempre algum ao seu alcance.
- O catálogo público: um repositório único, ordenado e acessível é um banco de ensaio gratuito. Jared Duker Lichtman, de Stanford, resume assim: “os laboratórios perceberam que isto podia funcionar como benchmark”.
Há uma quarta razão, menos vistosa. Uma parte dos problemas “em aberto” não o estava: a solução tinha sido publicada e ninguém a tinha ligado à pergunta. O caso do problema 333 é o exemplo extremo. Barreto publicou uma prova gerada com IA na manhã de Natal e, umas horas depois, outro utilizador colocou a ligação para o artigo de 1977 em que Erdős já o tinha resolvido. A conclusão que deixou à comunidade foi pedir “mais atenção à pesquisa bibliográfica”.
Um pormenor sobre quem faz este trabalho: Barreto é estudante de licenciatura. Liam Price, com quem trabalha, deixou a universidade sem terminar o curso. Wouter van Doorn trabalha no apoio ao cliente. Price reconhece, segundo a Quanta, que não tem formação para verificar ele próprio as provas que tira dos modelos. O que tem é um procedimento.
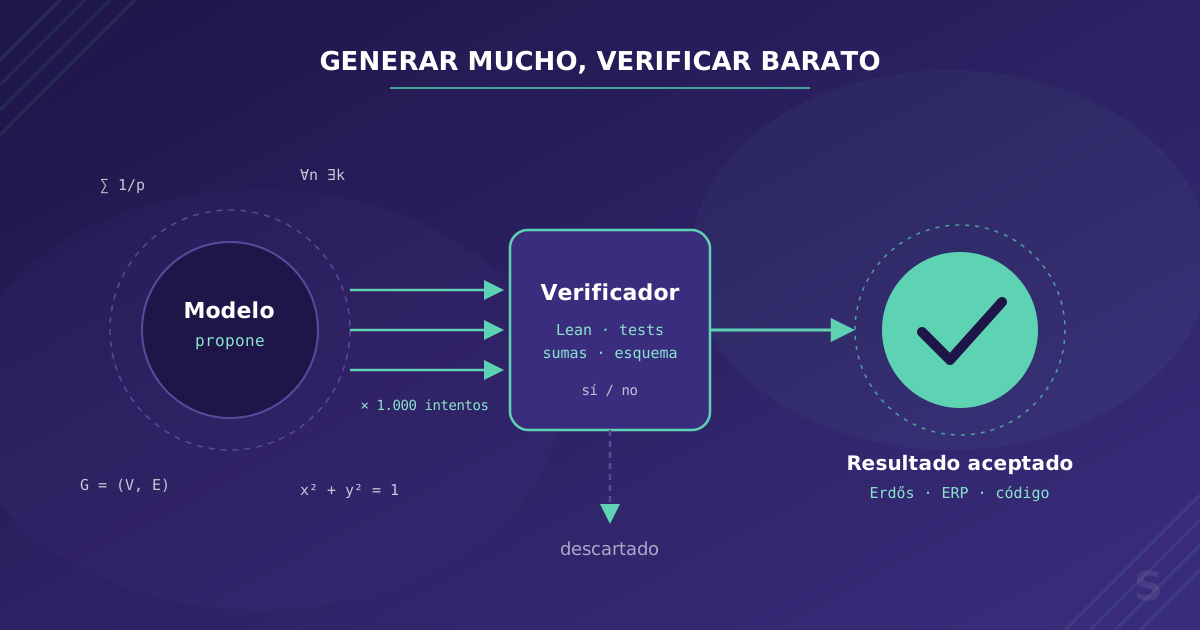
O padrão que se repete: gerar muito, verificar barato
O procedimento de Price consiste em pedir uma solução a um chatbot, passá-la a uma instância nova para que a reveja e repetir. David Woodruff, da Carnegie Mellon, descreve o mesmo princípio no trabalho que fez com a Google sobre um problema de ondas gravitacionais: “se o chamar muitas vezes, talvez numa delas acerte”. No seu sistema, o modelo propõe hipóteses, um verificador automático confirma a matemática e um investigador faz a revisão final.
Nos resultados mais sólidos da lista, o verificador é o Lean, um assistente de provas em que cada passo de uma demonstração é verificado mecanicamente. A OpenAI publicou os dez resultados do Astra com certificados em Lean 4 e zero sorry, a palavra com que o Lean marca um passo dado como bom sem ser demonstrado. Assim ninguém tem de confiar no modelo: se o Lean compila a prova, a prova está correta face ao enunciado formalizado.
A nota de Knuth segue o mesmo esquema, com humanos no papel de verificador. O Claude Opus 4.6 encontrou uma construção para decompor um grafo dirigido em três ciclos hamiltonianos quando o parâmetro é ímpar. Filip Stappers testou-a por computador para todos os valores ímpares até 101, e depois Knuth escreveu a demonstração geral.
As três histórias partilham a mesma estrutura:
- O modelo não é de confiança e ninguém o trata como se fosse.
- Há um verificador independente que diz sim ou não sem interpretar: o Lean, um programa que testa cem casos, outra instância do modelo com instruções para procurar falhas.
- Como verificar é barato, é possível gerar muitas propostas e ficar com as que passam.
Essa é a parte que se pode levar para uma empresa. A capacidade matemática do Astra não está disponível, e a maioria dos problemas de negócio também não precisa dela.
Onde está o “Lean” da sua empresa
A pergunta útil perante qualquer processo que se queira automatizar com IA é o que faz de verificador. Se existe e é barato, o modelo pode errar nove em cada dez vezes e o sistema funciona na mesma. Se não existe, cada erro chega ao cliente.
| Problema | Verificador barato | O que faz o modelo |
|---|---|---|
| Migrar dados de um ERP antigo | Contagens por tabela, somas de valores, chaves estrangeiras que resolvem | Escreve e corrige os scripts de transformação até tudo bater certo |
| Modernizar código legado | A suite de testes existente, o compilador, a tipagem | Propõe a alteração; se partir um teste, é descartada |
| Extrair dados de faturas ou guias de remessa | Validação contra esquema, base + IVA = total, NIF com dígito de controlo | Lê o documento; o que não bate certo vai para revisão humana |
| Gerar consultas SQL a partir de linguagem natural | Executar contra uma réplica e comparar com resultados conhecidos | Propõe a consulta |
| Planear turnos ou rotas | Restrições rígidas (horas máximas, janelas de entrega) e uma função de custo | Propõe planos ou, melhor, heurísticas que os geram |
| Redigir respostas de suporte | Fraco: rubrica avaliada por outro modelo e amostragem humana | Redige |
A última linha está lá de propósito. Há tarefas sem verificador mecânico, e nelas a técnica de Price (outra instância que revê) é o melhor que existe. Explicamo-lo em detalhe em LLM como juiz: funciona, mas tem de ser calibrado contra o juízo humano e é preciso vigiar os seus enviesamentos. Quanto mais acima na tabela, mais o problema se parece com um problema de Erdős, e melhor resultado dá a IA.
Para qualquer processo da coluna da esquerda, a regra prática é escrever o verificador antes do prompt. Uma equipa que começa pelo prompt acaba a afiná-lo a olho com cinco exemplos. Uma que começa pelo verificador pode testar quatro modelos e dez variantes de prompt numa tarde e ficar com a que passa mais casos.
AlphaEvolve: quando o verificador é uma função de custo
Há uma variante do padrão que serve para problemas de otimização, em que não existe uma resposta correta, apenas respostas melhores e piores. A Google DeepMind apresentou-a em maio de 2025 com o AlphaEvolve: um agente que escreve programas, executa-os contra um avaliador que lhes dá nota e faz evoluir os que pontuam melhor.
Em matemática, a equipa aplicou-o depois a 67 problemas, igualou a maioria das construções conhecidas e melhorou várias, com a participação de Terence Tao e Javier Gómez-Serrano. Mas o primeiro resultado que a DeepMind publicou não era matemático: uma heurística de planeamento para os centros de dados da Google que, segundo a empresa, recupera em média 0,7% da sua capacidade de computação mundial.
O que interessa a uma empresa é a forma do resultado. O AlphaEvolve não decide cada atribuição. Escreve um programa curto e legível que as decide, e esse programa é revisto, implementado e mantido como qualquer outro. Em processos como a distribuição de rotas, a atribuição de turnos ou a reposição de stock acontece o mesmo: se houver dados históricos para reproduzir semanas passadas e uma métrica que diga qual o melhor plano, é possível montar um ciclo deste tipo sem tocar no sistema de produção até haver um vencedor.
A longa lista de problemas para os quais ninguém olha
Antes da IA, a maioria dos problemas de Erdős não estava em aberto por ser difícil. Estava em aberto porque não compensava a ninguém: um especialista podia resolver muitos numa semana, mas tinha coisas mais importantes para fazer. Noga Alon, de Princeton, disse-o na Quanta ao explicar porque deixou de trabalhar neles: “a partir do momento em que a IA começou a resolvê-los, já não faz sentido”.
Todas as empresas têm a sua própria lista de problemas de Erdős. A integração que alguém faz à mão todas as segundas-feiras com uma folha de cálculo. Os 2.000 produtos com a descrição vazia. O relatório que alguém refaz todos os trimestres copiando de três sítios. O script de 2014 em que ninguém se atreve a mexer. Nenhum justifica um projeto, e por isso estão há anos no backlog.
O que mudou foi o custo por problema. O agente da DeepMind resolvia cada problema de Erdős por algumas centenas de dólares. Os dez resultados do Astra custaram, segundo a SiliconANGLE, cerca de 2.000 dólares a preço de API. No outro extremo, o TechCrunch calcula que a prova de Navier-Stokes consumiu 300 mil milhões de tokens de saída, cerca de 22,5 milhões de dólares à tarifa do Astra. O custo cresce com a dificuldade, e a maior parte do que está num backlog fica no extremo barato. Os números de cada modelo estão detalhados em quanto custa realmente executar LLMs em produção.
Para ordenar essa lista vale o mesmo critério que nos problemas matemáticos: primeiro os que têm verificador barato e pouco valor individual, porque são os que ninguém ia atacar à mão e onde um erro é detetado antes de causar danos.
Antes de resolver, procure
O problema 333 deixa uma lição mais prosaica. Uma parte importante do que foi celebrado como “a IA resolve um problema em aberto” foi a IA a encontrar uma solução que já estava publicada. Bloom disse-o em outubro de 2025, quando a OpenAI afirmou que o GPT-5 tinha resolvido dez problemas de Erdős: eram descobertas bibliográficas.
Isso tem valor, e numa empresa é o caso de uso mais frequente. A resposta à pergunta do cliente costuma estar num PDF de 2019, numa troca de emails ou na cabeça de alguém que se reforma no próximo ano. Um sistema que a encontra e a cita poupa mais horas do que um que raciocina do zero, e erra menos. Mas só funciona se o conhecimento estiver num sítio onde se possa pesquisar, que é o tema de preparar uma base de conhecimento para IA.
A ordem prática é procurar primeiro, raciocinar depois e assinalar sempre qual das duas coisas o sistema fez. Uma resposta citada verifica-se abrindo a fonte. Uma raciocinada precisa de outro verificador.
O estrangulamento passa para a revisão
Thomas Bloom, na Quanta, sobre uma das provas geradas: “Mas nenhum humano a leu, e nenhum humano a vai ler. Agora é um desafio enorme”. No início de outubro a OpenAI publicou centenas de manuscritos de uma só vez, e parte da comunidade matemática respondeu pedindo um boicote. Gerar deixou de ser a parte cara. Rever continua a custar o mesmo que antes.
Numa empresa acontece o mesmo, noutra escala. Um agente que abre quarenta pull requests por dia ou que propõe duzentas fichas de produto por hora não acelera nada se a equipa só conseguir rever dez. As alterações acumulam-se, a revisão torna-se superficial e os erros passam.
O que funciona é repartir a revisão por camadas:
- Verificação automática de tudo o que se possa comprovar mecanicamente. O que não passa não chega a nenhuma pessoa.
- Avaliação por outro modelo, com uma rubrica, para o que resta, ordenando por risco.
- Revisão humana do que o avaliador marca como duvidoso e de uma amostra aleatória do resto, para detetar se o avaliador se desviou.
Com a prova de Navier-Stokes nem isso basta, porque o resultado é novo e ninguém tem com que o comparar. A NPR resumiu-o num título: a IA resolveu um dos problemas mais difíceis da matemática e a humanidade não aprendeu nada (por enquanto). Num processo de negócio, o equivalente é aceitar uma alteração que funciona sem que ninguém na equipa perceba porquê. Para código que alguém vai ter de manter, isso é uma dívida.
Dados e autoria: o que ensina a disputa de Navier-Stokes
No próprio dia do anúncio, o TechCrunch publicou a versão de Tristan Buckmaster, matemático da NYU que trabalhava no problema com Levent Alpöge, da Anthropic. Buckmaster afirma que Sébastien Bubeck, da OpenAI, lhe pediu para retirar o crédito a Alpöge. Buckmaster tinha usado o Codex, a ferramenta de programação da OpenAI, durante o seu trabalho. Segundo o TechCrunch, a publicação da OpenAI diz: “embora seja pouco provável, não podemos excluir que dados desidentificados derivados da sua utilização dos nossos produtos tenham ajudado a melhorar os nossos modelos”.
Seja qual for o desfecho, a frase vale para qualquer empresa que coloque o seu código, os seus contratos ou os dados dos seus clientes numa ferramenta de IA. Antes de o fazer, é preciso saber se o plano contratado exclui o treino com os seus dados, o que fica retido e durante quanto tempo, e onde é processado. Os planos empresariais dos principais fornecedores permitem-no; os gratuitos e alguns pagos individuais, nem sempre. É uma caixa num contrato, e convém assinalá-la antes do primeiro prompt.
Como saber se o seu problema tem “forma de Erdős”
Cinco perguntas para decidir se um processo é bom candidato para ser resolvido com IA, pela ordem em que as fazemos:
- Há um verificador barato? Um teste, uma soma que tem de bater certo, um esquema, uma restrição. Se a única forma de saber se o resultado está certo é um especialista olhar para ele, a IA serve de rascunho, não de sistema.
- É possível gerar muitas tentativas? Se cada tentativa tem efeitos no mundo real (um email enviado, uma encomenda lançada), primeiro é preciso montar um ambiente onde não os tenha.
- Já está resolvido nalgum sítio? Na documentação interna, no histórico de tickets, na biblioteca que já existe. Procurar é mais barato do que raciocinar.
- Quem vai rever o volume que sair? Se a resposta é “a mesma equipa que agora não tem mãos a medir”, o desenho da revisão faz parte do projeto.
- Pode colocar os seus dados na ferramenta? Reveja as condições de utilização antes da prova de conceito, não depois.
Um processo que responde bem às três primeiras parece-se mais com um problema de Erdős do que com Navier-Stokes, e costuma ficar pronto em semanas.
O que fazemos com isto
Nos projetos de agentes de IA tratamos a avaliação como uma especialidade à parte: antes de escolher modelo ou escrever prompts, definimos o que conta como resultado correto e como se verifica de forma automática. Isso permite comparar modelos com dados e não com impressões, e saber se uma mudança de versão do fornecedor piorou alguma coisa antes de um cliente dar por isso.
Se tem no backlog uma lista de tarefas que ninguém ataca porque não compensam, fale-nos de três. Diremos quais têm verificador, quais precisam de o construir e quais convém deixar nas mãos de uma pessoa. Pode escrever-nos a partir da página de inteligência artificial.