LLM
Todo lo específico de trabajar con modelos de lenguaje: comparativas de modelos con criterios de coste y latencia, cuándo RAG resuelve mejor que fine-tuning, y cómo evitar que la factura de tokens se descontrole al escalar.
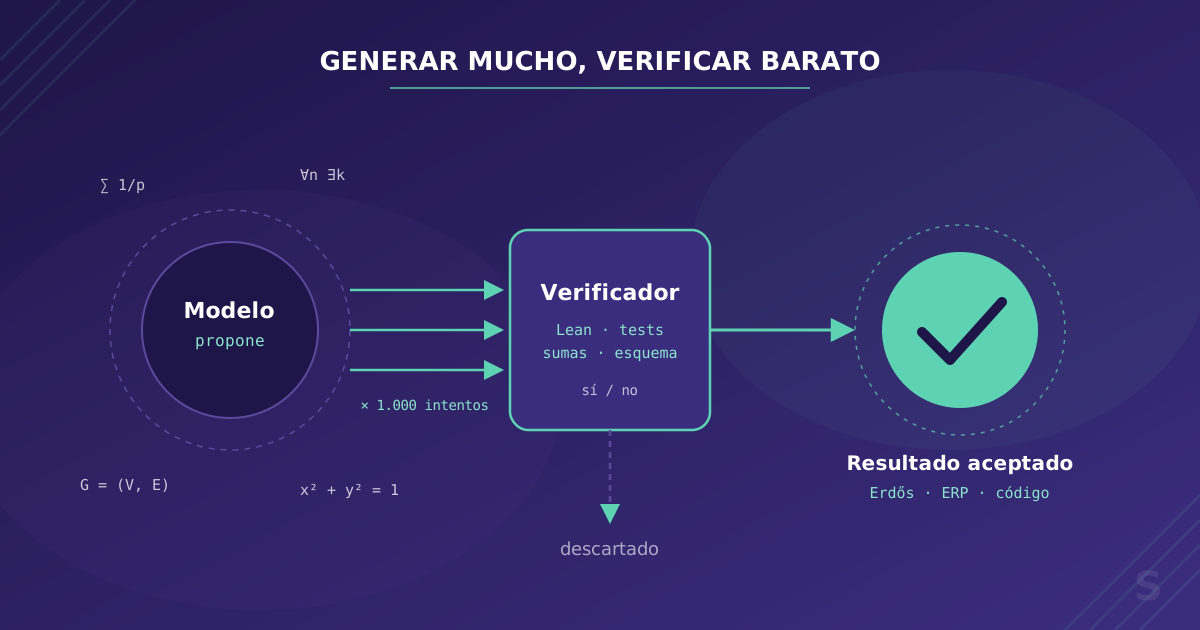
La IA está resolviendo problemas matemáticos abiertos: qué puede copiar una empresa del método
Erdős, Navier-Stokes, AlphaEvolve: qué ha resuelto la IA en matemáticas en 2026, por qué funciona y cómo aplicar el patrón al software de tu empresa.
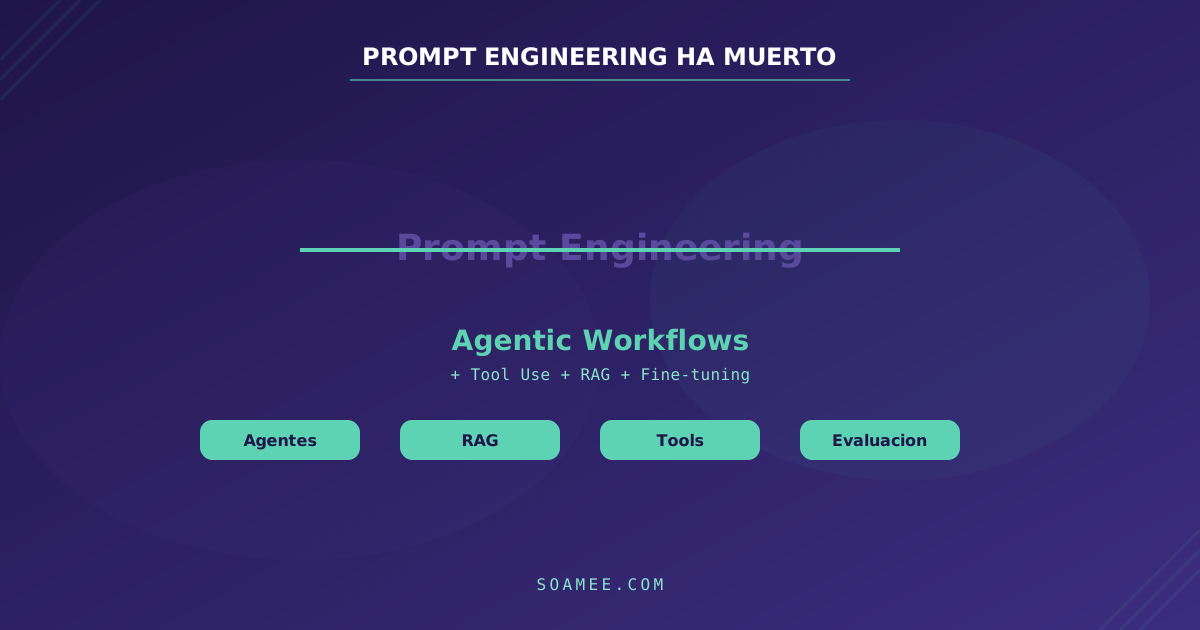
Prompt engineering ha muerto. Esto es lo que lo ha sustituido
Por qué el prompt engineering como disciplina aislada está muerto y qué lo está reemplazando: structured outputs, tool use y context engineering.
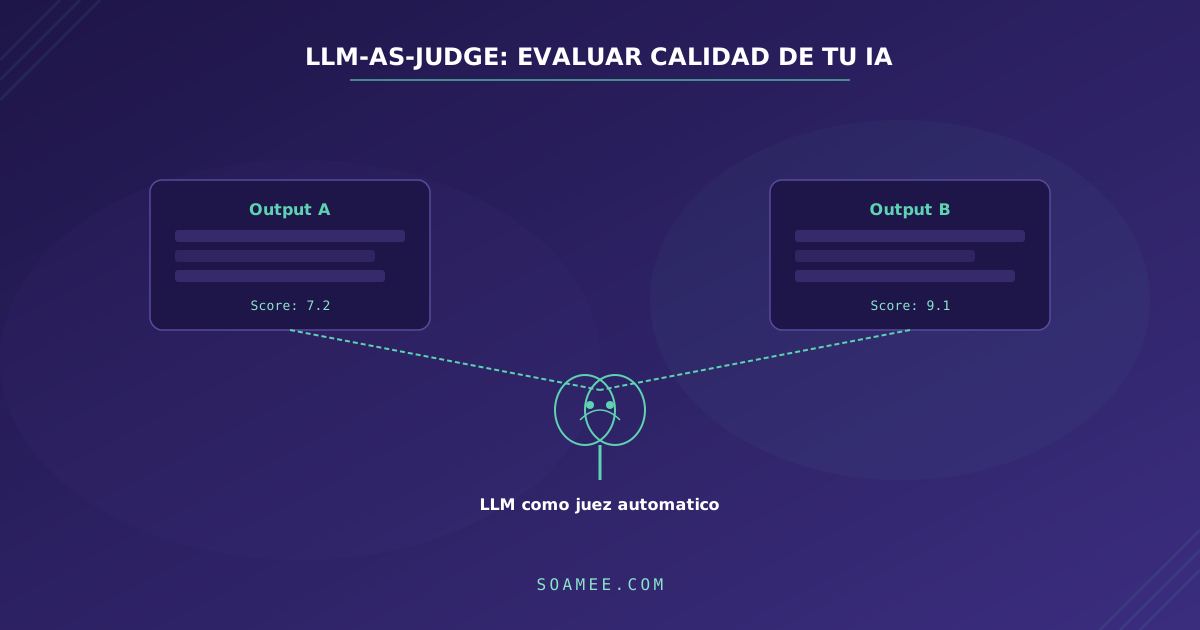
LLM-as-judge: cómo evaluar automáticamente la calidad de tu IA en producción
Guía práctica para usar LLMs como evaluadores de calidad en producción: frameworks, métricas, código y errores comunes.
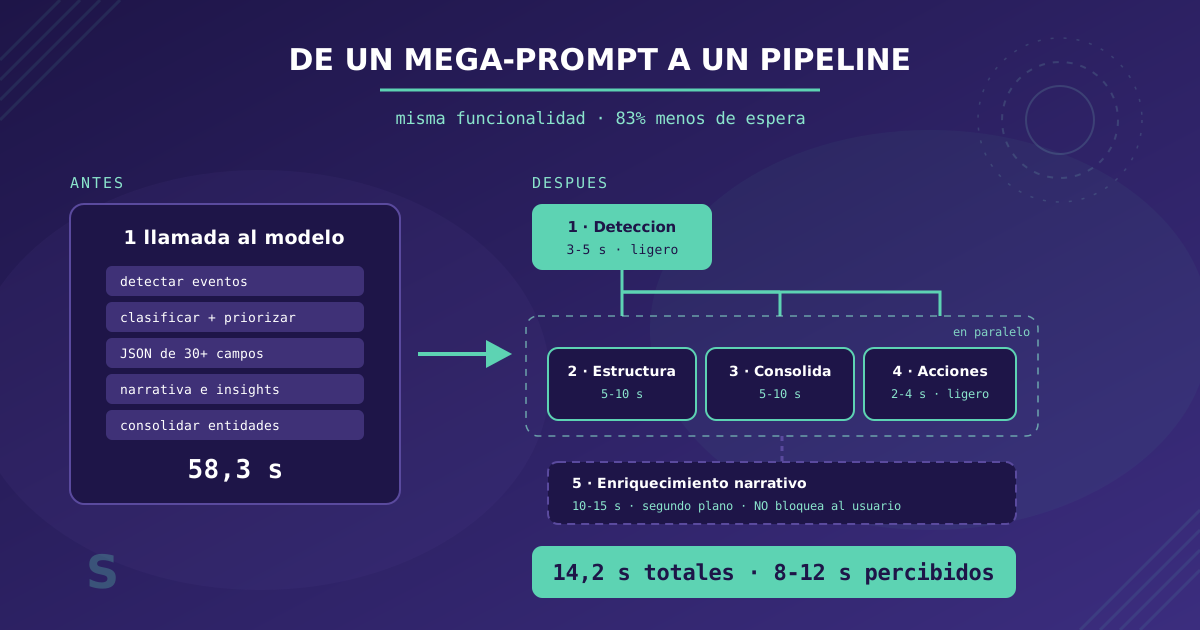
De un mega-prompt a un pipeline: cómo bajamos un proceso de IA de 58s a 14s
Dividir un prompt monolítico en pasos especializados bajó la latencia de 58s a 14s. Arquitectura, medidas reales y ejemplos de prompting.
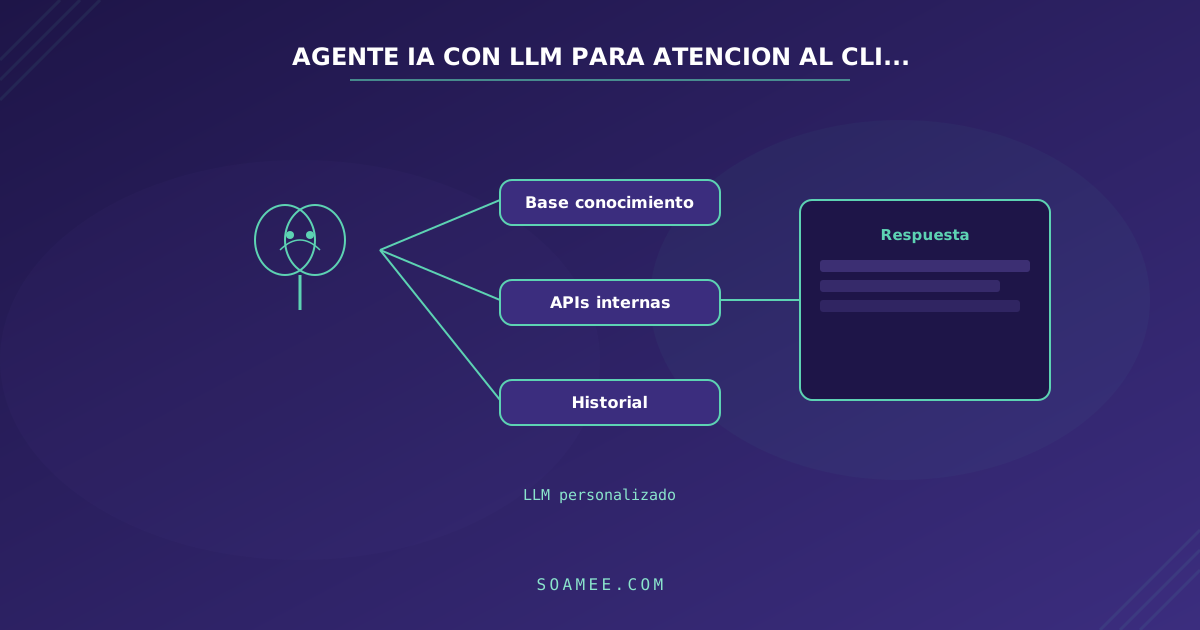
Cómo crear un agente IA con LLM para atención al cliente
Guía técnica para construir un agente IA con LLM que atienda clientes de forma personalizada, superando los chatbots genéricos.
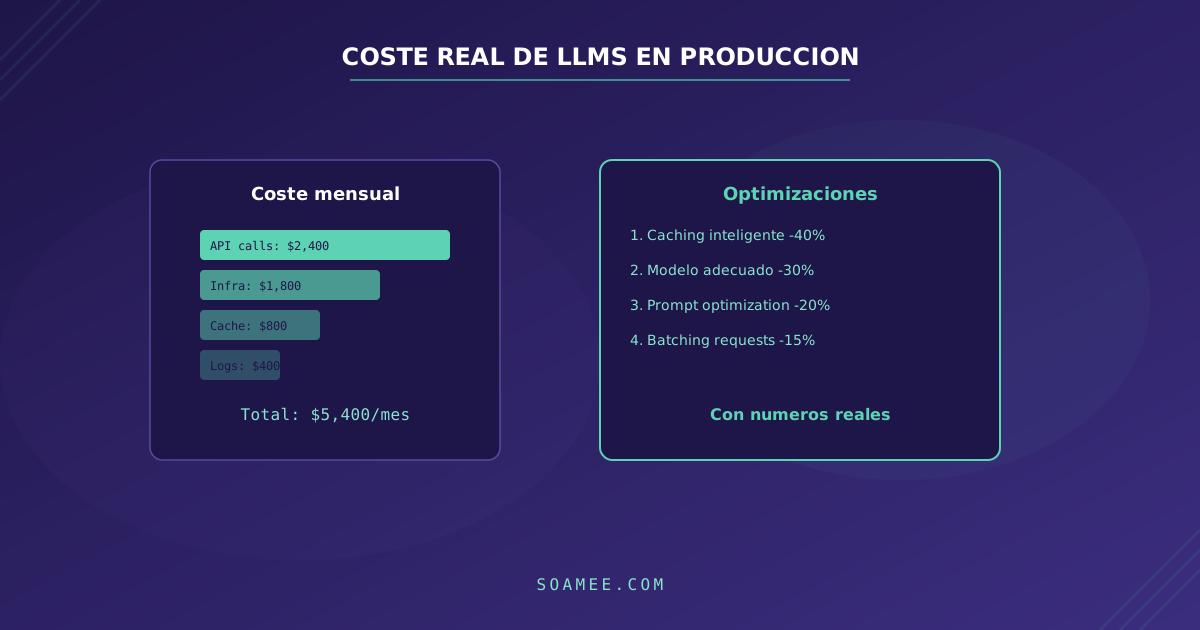
Lo que cuesta realmente ejecutar LLMs en producción (con números)
Desglose real de costes de LLMs en producción: tokens, infraestructura, latencia y estrategias de optimización con datos actuales.
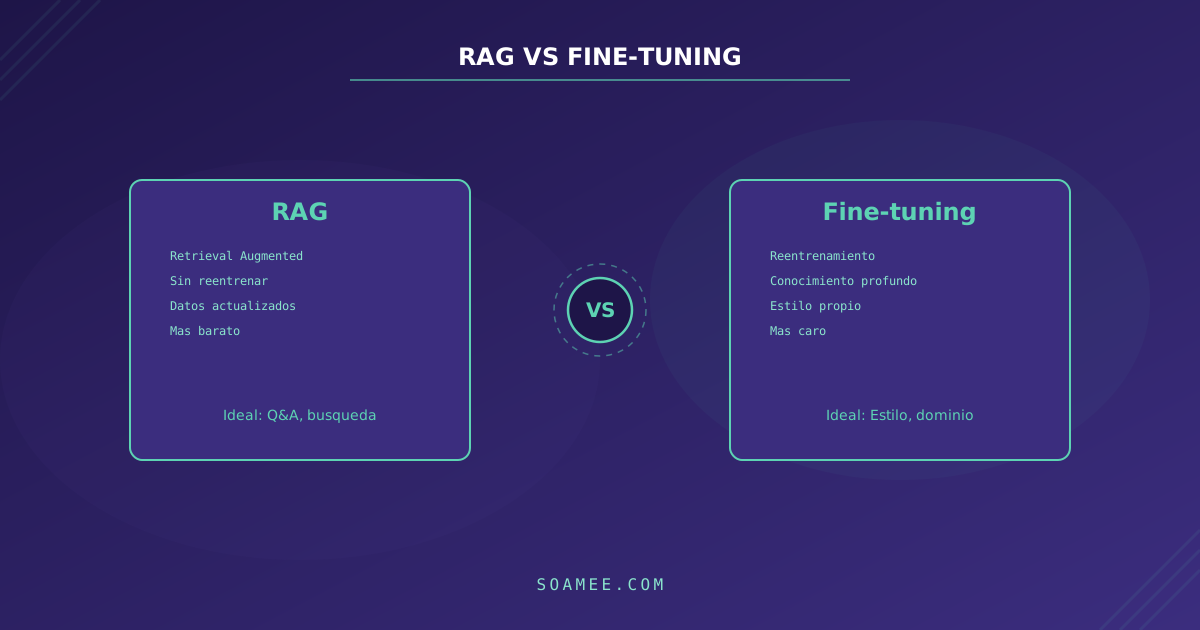
RAG vs fine-tuning: cuándo usar cada enfoque
Cómo elegir entre RAG y fine-tuning en IA empresarial. Comparativa de costes, rendimiento y framework de decisión 2026.
Cuéntanos tu reto. Te proponemos solución.
Sin compromiso. En menos de 24 h recibes una propuesta con alcance, plazos y presupuesto. Sin letra pequeña.