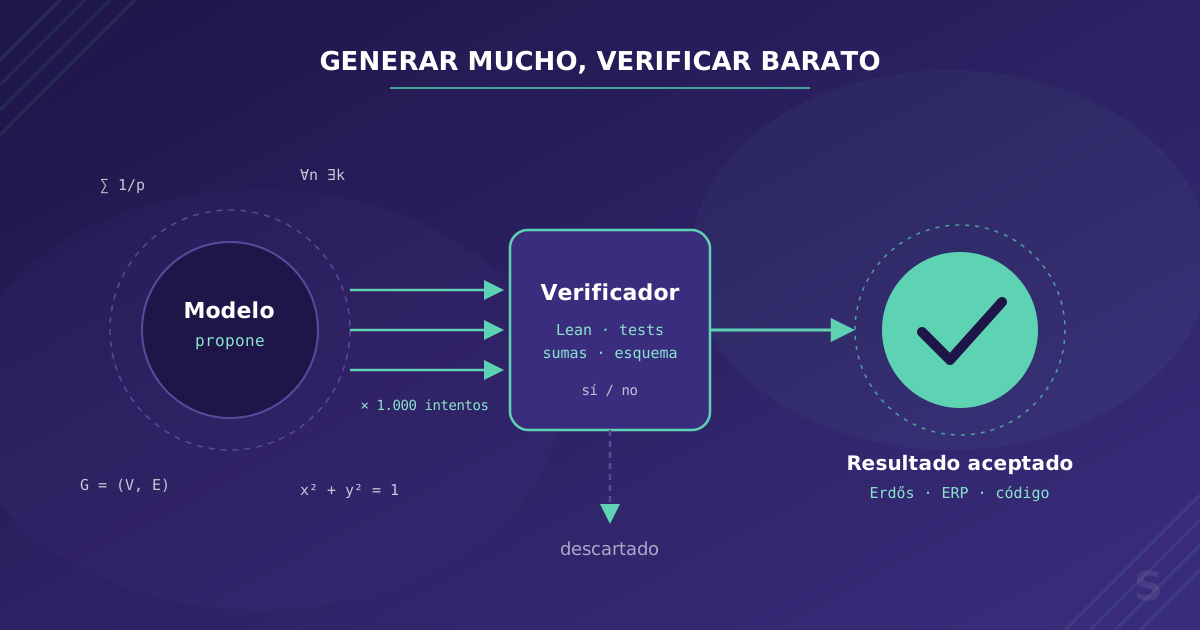
In nove mesi del 2026 l’IA è passata dal ritrovare nella letteratura soluzioni dimenticate a problemi di Erdős a OpenAI che pubblica quella che presenta come una prova completa di Navier-Stokes, uno dei sette problemi del millennio. Nel frattempo una medaglia Fields ha lasciato l’università per andare a OpenAI, un matematico di Princeton ha smesso di lavorare sui problemi di Erdős perché “ormai non ha più senso”, e il curatore del più grande catalogo di quei problemi ha ammesso che ci sono prove che nessun essere umano leggerà.
Noi non risolveremo l’ipotesi di Riemann. Ma il metodo con cui si ottengono questi risultati è lo stesso che separa un agente di IA che funziona in produzione da uno che resta una demo, e quasi nessuno lo racconta da questo punto di vista. Qui ripercorriamo cosa è successo, perché ha funzionato e cosa si può copiare nel software di un’azienda.
Cosa è successo nel 2026, in ordine
| Data | Chi | Cosa | Stato |
|---|---|---|---|
| 25 dic 2025 | Kevin Barreto (studente di Cambridge) | Pubblica una prova generata con l’IA del problema di Erdős 333 | Ritirata in poche ore: Erdős l’aveva già risolto in un articolo del 1977 |
| 4 gen 2026 | Barreto, con GPT-5.2 Pro e Aristotle (Harmonic) | Risolve il problema di Erdős 728 e certifica la prova in Lean | Pubblicata su arXiv |
| 28 feb 2026 | Donald Knuth | Pubblica “Claude’s Cycles”: Claude Opus 4.6 trova una costruzione per un problema di cicli hamiltoniani che Knuth aveva lasciato aperto | Knuth scrive la dimostrazione a mano |
| 20 mag 2026 | OpenAI (modello interno) | Controesempio alla congettura di Erdős sulle distanze unitarie, del 1946 | Revisionato da matematici esterni; gli umani l’hanno migliorato in poche settimane |
| maggio 2026 | Google DeepMind | Il suo agente migliore risolve 9 dei 353 problemi di Erdős formalizzati | Paper con 21 autori |
| 1-2 ago 2026 | OpenAI | Annuncia il modello Astra con 10 risultati nuovi e i relativi certificati in Lean 4 | Senza revisione paritaria |
| 8 set 2026 | OpenAI | Pubblica una prova di esistenza e regolarità di Navier-Stokes | In revisione e con una disputa sulla paternità |
| 22 set 2026 | OpenAI | Dichiara che un modello interno ha risolto oltre 100 problemi aperti | Pubblica centinaia di manoscritti all’inizio di ottobre |
La tabella mescola due cose diverse, ed è meglio tenerle separate. I problemi di Erdős sono centinaia di domande di difficoltà molto disomogenea, molte delle quali quasi nessuno aveva guardato sul serio. Navier-Stokes è un problema che ha resistito ai migliori matematici per decenni. Che cadano i primi dice molto sul metodo. Che cada il secondo, se verrà confermato, dice qualcosa sulla capacità grezza dei modelli. A un’azienda interessa soprattutto la prima cosa.
Perché cadono i problemi di Erdős e non altri
Paul Erdős ha lasciato più di mille articoli e un’abitudine: porre problemi, a volte con una ricompensa in dollari. Thomas Bloom, oggi all’Università di Manchester, ha iniziato a raccoglierli su erdosproblems.com all’inizio del 2023, partendo da un paio di centinaia. Ad agosto 2025 erano quasi mille. Secondo Quanta Magazine, ad agosto 2026 il database contava 565 problemi risolti e 652 aperti.
Quanta indica tre ragioni per cui l’IA avanza qui e non in altre aree:
- Il terreno: i problemi riguardano soprattutto teoria dei numeri, combinatoria e teoria dei grafi, le aree in cui i modelli linguistici si sono dimostrati più capaci.
- La difficoltà disomogenea: ci sono problemi banali per uno specialista e altri che nessuno ha mai toccato. Una tecnologia con capacità altrettanto disomogenee ne trova sempre qualcuno alla sua portata.
- Il catalogo pubblico: un repository unico, ordinato e accessibile è un banco di prova gratuito. Jared Duker Lichtman, di Stanford, la riassume così: “i laboratori si sono resi conto che poteva funzionare come benchmark”.
C’è una quarta ragione, meno appariscente. Una parte dei problemi “aperti” in realtà non lo era: la soluzione era già pubblicata e nessuno l’aveva collegata alla domanda. Il problema 333 è il caso estremo. Barreto ha pubblicato una prova generata con l’IA la mattina di Natale e poche ore dopo un altro utente ha linkato l’articolo del 1977 in cui Erdős l’aveva già risolto. La sua conclusione, rivolta alla comunità, è stata chiedere “più attenzione alla ricerca bibliografica”.
Un dettaglio su chi fa questo lavoro: Barreto è uno studente di laurea triennale. Liam Price, con cui lavora, ha lasciato l’università senza finirla. Wouter van Doorn lavora nell’assistenza clienti. Price riconosce, secondo Quanta, di non avere la formazione per verificare da solo le prove che ottiene dai modelli. Quello che ha è una procedura.
Lo schema che si ripete: generare tanto, verificare a basso costo
La procedura di Price consiste nel chiedere una soluzione a un chatbot, passarla a una nuova istanza perché la riveda e ripetere. David Woodruff, della Carnegie Mellon, descrive lo stesso principio nel lavoro che ha fatto con Google su un problema di onde gravitazionali: “se lo chiamo molte volte, forse una di queste azzecca”. Nel suo sistema il modello propone ipotesi, un verificatore automatico controlla la matematica e un ricercatore fa la revisione finale.
Nei risultati più solidi della lista il verificatore è Lean, un assistente di dimostrazione in cui ogni passaggio viene controllato meccanicamente. OpenAI ha pubblicato i dieci risultati di Astra con certificati in Lean 4 e zero sorry, la parola con cui Lean segna un passaggio dato per buono senza dimostrarlo. Così nessuno deve fidarsi del modello: se Lean compila la prova, la prova è corretta rispetto all’enunciato formalizzato.
La nota di Knuth segue lo stesso schema, con gli umani nel ruolo di verificatore. Claude Opus 4.6 ha trovato una costruzione per scomporre un grafo orientato in tre cicli hamiltoniani quando il parametro è dispari. Filip Stappers l’ha testata al computer per tutti i valori dispari fino a 101, e poi Knuth ha scritto la dimostrazione generale.
Le tre storie hanno la stessa struttura:
- Il modello non è affidabile e nessuno lo tratta come se lo fosse.
- C’è un verificatore indipendente che dice sì o no senza interpretare: Lean, un programma che prova cento casi, un’altra istanza del modello istruita a cercare errori.
- Siccome verificare costa poco, si possono generare molte proposte e tenere quelle che passano.
È questa la parte che si può portare in azienda. La capacità matematica di Astra non è disponibile, e per la maggior parte dei problemi di business non serve nemmeno.
Dov’è il “Lean” della tua azienda
La domanda utile davanti a qualsiasi processo da automatizzare con l’IA è: chi fa da verificatore? Se esiste ed è economico, il modello può sbagliare nove volte su dieci e il sistema funziona lo stesso. Se non esiste, ogni errore arriva al cliente.
| Problema | Verificatore economico | Cosa fa il modello |
|---|---|---|
| Migrare dati da un vecchio ERP | Conteggi per tabella, somme degli importi, chiavi esterne che si risolvono | Scrive e corregge gli script di trasformazione finché i conti tornano |
| Modernizzare codice legacy | La suite di test esistente, il compilatore, la tipizzazione | Propone la modifica; se rompe un test, viene scartata |
| Estrarre dati da fatture o DDT | Validazione contro schema, imponibile + IVA = totale, partita IVA con cifra di controllo | Legge il documento; ciò che non torna va in revisione umana |
| Generare query SQL dal linguaggio naturale | Eseguirle su una replica e confrontarle con risultati noti | Propone la query |
| Pianificare turni o percorsi | Vincoli rigidi (ore massime, finestre di consegna) e una funzione di costo | Propone piani o, meglio, euristiche che li generano |
| Scrivere risposte di assistenza | Debole: rubrica valutata da un altro modello e campionamento umano | Scrive |
L’ultima riga è lì apposta. Ci sono compiti senza un verificatore meccanico, e per quelli la tecnica di Price (un’altra istanza che rivede) è il meglio che c’è. Lo spieghiamo in dettaglio in LLM come giudice: funziona, ma va calibrato sul giudizio umano e bisogna tenerne d’occhio i bias. Più si sale nella tabella, più il problema somiglia a un problema di Erdős e migliore è il risultato dell’IA.
Per qualsiasi processo della colonna di sinistra, la regola pratica è scrivere il verificatore prima del prompt. Un team che parte dal prompt finisce per regolarlo a occhio su cinque esempi. Uno che parte dal verificatore può provare quattro modelli e dieci varianti di prompt in un pomeriggio e tenere quella che supera più casi.
AlphaEvolve: quando il verificatore è una funzione di costo
Esiste una variante dello schema che serve per i problemi di ottimizzazione, dove non c’è una risposta corretta ma risposte migliori e peggiori. Google DeepMind l’ha presentata a maggio 2025 con AlphaEvolve: un agente che scrive programmi, li esegue contro un valutatore che assegna un punteggio e fa evolvere quelli che ottengono il punteggio migliore.
In matematica il team l’ha poi applicato a 67 problemi, ha eguagliato la maggior parte delle costruzioni note e ne ha migliorate diverse, con la partecipazione di Terence Tao e Javier Gómez-Serrano. Ma il primo risultato pubblicato da DeepMind non era matematico: un’euristica di pianificazione per i data center di Google che, secondo l’azienda, recupera in media lo 0,7% della sua capacità di calcolo mondiale.
Per un’azienda conta la forma del risultato. AlphaEvolve non decide ogni singola assegnazione. Scrive un programma breve e leggibile che le decide, e quel programma si rivede, si rilascia e si mantiene come qualsiasi altro. Nei processi come la distribuzione dei percorsi, l’assegnazione dei turni o il riassortimento delle scorte vale lo stesso: se ci sono dati storici per riprodurre le settimane passate e una metrica che dica quale piano è migliore, si può montare un ciclo di questo tipo senza toccare il sistema di produzione finché non c’è un vincitore.
La lunga lista di problemi che nessuno guarda
Prima dell’IA, la maggior parte dei problemi di Erdős non era aperta perché difficile. Era aperta perché non conveniva a nessuno: uno specialista poteva risolverne molti in una settimana, ma aveva cose più importanti da fare. Noga Alon, di Princeton, l’ha detto a Quanta spiegando perché ha smesso di occuparsene: “da quando l’IA ha cominciato a risolverli, non ha più senso”.
Ogni azienda ha la sua lista di problemi di Erdős. L’integrazione fatta a mano ogni lunedì con un foglio di calcolo. I 2.000 prodotti con la descrizione vuota. Il report che qualcuno rifà ogni trimestre copiando da tre posti diversi. Lo script del 2014 che nessuno osa toccare. Nessuno di questi giustifica un progetto, ed è per questo che stanno nel backlog da anni.
Quello che è cambiato è il costo per problema. L’agente di DeepMind risolveva ogni problema di Erdős con qualche centinaio di dollari. I dieci risultati di Astra sono costati, secondo SiliconANGLE, circa 2.000 dollari a prezzo di API. All’estremo opposto, TechCrunch calcola che la prova di Navier-Stokes abbia consumato 300 miliardi di token di output, circa 22,5 milioni di dollari alla tariffa di Astra. Il costo cresce con la difficoltà, e la maggior parte di ciò che c’è in un backlog sta all’estremo economico. I numeri di ogni modello li scomponiamo in quanto costa eseguire LLM in produzione.
Per ordinare quella lista vale lo stesso criterio dei problemi matematici: prima quelli con un verificatore economico e poco valore individuale, perché sono quelli che nessuno avrebbe affrontato a mano e dove un errore si scopre prima che faccia danni.
Prima di risolvere, cerca
Il problema 333 lascia una lezione più prosaica. Una parte importante di ciò che è stato celebrato come “l’IA risolve un problema aperto” era l’IA che trovava una soluzione già pubblicata. Bloom l’ha detto a ottobre 2025, quando OpenAI ha affermato che GPT-5 aveva risolto dieci problemi di Erdős: erano scoperte bibliografiche.
Anche questo ha valore, e in un’azienda è il caso d’uso più frequente. La risposta alla domanda del cliente sta spesso in un PDF del 2019, in un thread di email o nella testa di qualcuno che va in pensione l’anno prossimo. Un sistema che la trova e la cita fa risparmiare più ore di uno che ragiona da zero, e sbaglia meno. Ma funziona solo se la conoscenza sta in un posto dove si può cercare, ed è il tema di preparare una base di conoscenza per l’IA.
L’ordine pratico è cercare prima, ragionare dopo e segnalare sempre quale delle due cose ha fatto il sistema. Una risposta citata si verifica aprendo la fonte. Una ragionata ha bisogno di un altro verificatore.
Il collo di bottiglia si sposta sulla revisione
Thomas Bloom, su Quanta, a proposito di una delle prove generate: “Ma nessun essere umano l’ha letta, e nessun essere umano la leggerà. Adesso è una sfida enorme”. All’inizio di ottobre OpenAI ha pubblicato centinaia di manoscritti in un colpo solo, e parte della comunità matematica ha risposto chiedendo un boicottaggio. Generare ha smesso di essere la parte costosa. Revisionare costa quanto prima.
In un’azienda succede lo stesso, su un’altra scala. Un agente che apre quaranta pull request al giorno o che propone duecento schede prodotto all’ora non accelera nulla se il team riesce a revisionarne dieci. Le modifiche si accumulano, la revisione diventa superficiale e gli errori passano.
Quello che funziona è distribuire la revisione su più livelli:
- Verifica automatica di tutto ciò che si può controllare meccanicamente. Ciò che non passa non arriva a nessuna persona.
- Valutazione da parte di un altro modello con una rubrica per ciò che resta, ordinando per rischio.
- Revisione umana di ciò che il valutatore segna come dubbio e di un campione casuale del resto, per accorgersi se il valutatore ha deviato.
Con la prova di Navier-Stokes neanche questo basta, perché il risultato è nuovo e nessuno ha qualcosa con cui confrontarlo. NPR l’ha riassunto in un titolo: l’IA ha risolto uno dei problemi più difficili della matematica e l’umanità non ha imparato niente (per ora). In un processo aziendale l’equivalente è accettare una modifica che funziona senza che nessuno nel team capisca perché. Per codice che qualcuno dovrà mantenere, è un debito.
Dati e paternità: cosa insegna la disputa su Navier-Stokes
Il giorno stesso dell’annuncio, TechCrunch ha pubblicato la versione di Tristan Buckmaster, matematico della NYU che lavorava al problema insieme a Levent Alpöge, di Anthropic. Buckmaster sostiene che Sébastien Bubeck, di OpenAI, gli abbia chiesto di togliere il credito ad Alpöge. Buckmaster aveva usato Codex, lo strumento di programmazione di OpenAI, durante il suo lavoro. Secondo TechCrunch, la pubblicazione di OpenAI dice: “anche se è poco probabile, non possiamo escludere che dati de-identificati derivati dal suo uso dei nostri prodotti abbiano contribuito a migliorare i nostri modelli”.
Comunque vada a finire, la frase vale per qualsiasi azienda che metta il proprio codice, i contratti o i dati dei clienti in uno strumento di IA. Prima di farlo bisogna sapere se il piano sottoscritto esclude l’addestramento sui tuoi dati, cosa viene conservato e per quanto tempo, e dove avviene il trattamento. I piani enterprise dei principali fornitori lo consentono; quelli gratuiti e alcuni piani individuali a pagamento non sempre. È una casella in un contratto, ed è meglio spuntarla prima del primo prompt.
Come capire se il tuo problema ha la “forma di Erdős”
Cinque domande per decidere se un processo è un buon candidato da risolvere con l’IA, nell’ordine in cui le facciamo noi:
- C’è un verificatore economico? Un test, una somma che deve tornare, uno schema, un vincolo. Se l’unico modo per sapere se il risultato è giusto è farlo guardare a un esperto, l’IA serve come bozza, non come sistema.
- Si possono generare molti tentativi? Se ogni tentativo ha effetti nel mondo reale (un’email inviata, un ordine lanciato), prima bisogna allestire un ambiente in cui non ne abbia.
- È già stato risolto da qualche parte? Nella documentazione interna, nello storico dei ticket, nella libreria che esiste già. Cercare costa meno che ragionare.
- Chi revisionerà il volume prodotto? Se la risposta è “lo stesso team che oggi non ce la fa”, il design della revisione fa parte del progetto.
- Puoi mettere i tuoi dati nello strumento? Controlla le condizioni d’uso prima della proof of concept, non dopo.
Un processo che risponde bene alle prime tre domande somiglia più a un problema di Erdős che a Navier-Stokes, e di solito si chiude in qualche settimana.
Cosa ne facciamo noi
Nei progetti di agenti di IA trattiamo la valutazione come una disciplina a sé: prima di scegliere il modello o scrivere i prompt, definiamo cosa conta come risultato corretto e come si verifica in modo automatico. Così si possono confrontare i modelli sui dati e non sulle impressioni, e si sa se un cambio di versione del fornitore ha peggiorato qualcosa prima che se ne accorga un cliente.
Se nel backlog hai una lista di attività che nessuno affronta perché non conviene, raccontacene tre. Ti diremo quali hanno un verificatore, quali hanno bisogno di costruirlo e quali conviene lasciare in mano a una persona. Puoi scriverci dalla pagina di intelligenza artificiale.