In neun Monaten des Jahres 2026 ist KI von der Wiederentdeckung vergessener Lösungen zu Erdős-Problemen in der Fachliteratur dahin gekommen, dass OpenAI veröffentlicht, was es als vollständigen Beweis für Navier-Stokes präsentiert, eines der sieben Millennium-Probleme. Unterwegs hat ein Fields-Medaillenträger die Universität verlassen und ist zu OpenAI gewechselt, ein Mathematiker aus Princeton hat die Arbeit an Erdős-Problemen eingestellt, weil es “keinen Sinn mehr ergibt”, und der Betreiber des größten Katalogs dieser Probleme hat eingeräumt, dass es Beweise gibt, die kein Mensch je lesen wird.
Wir werden die Riemannsche Vermutung nicht lösen. Aber die Methode hinter diesen Ergebnissen ist dieselbe, die einen KI-Agenten, der in der Produktion funktioniert, von einem unterscheidet, der eine Demo bleibt. Aus dieser Perspektive erzählt das kaum jemand. Dieser Beitrag fasst zusammen, was passiert ist, warum es funktioniert hat und was sich davon in Unternehmenssoftware übernehmen lässt.
Was 2026 passiert ist, der Reihe nach
| Datum | Wer | Was | Status |
|---|---|---|---|
| 25. Dez. 2025 | Kevin Barreto (Student in Cambridge) | Veröffentlicht einen KI-generierten Beweis für Erdős-Problem 333 | Nach wenigen Stunden zurückgezogen: Erdős hatte es bereits in einem Artikel von 1977 gelöst |
| 4. Jan. 2026 | Barreto, mit GPT-5.2 Pro und Aristotle (Harmonic) | Löst Erdős-Problem 728 und zertifiziert den Beweis in Lean | Auf arXiv veröffentlicht |
| 28. Feb. 2026 | Donald Knuth | Veröffentlicht “Claude’s Cycles”: Claude Opus 4.6 findet eine Konstruktion für ein Problem über Hamiltonkreise, das Knuth offen hatte | Knuth schreibt den Beweis von Hand |
| 20. Mai 2026 | OpenAI (internes Modell) | Gegenbeispiel zu Erdős’ Vermutung über Einheitsabstände von 1946 | Von externen Mathematikern geprüft; Menschen haben es binnen Wochen verbessert |
| Mai 2026 | Google DeepMind | Sein bester Agent löst 9 von 353 formalisierten Erdős-Problemen | Paper mit 21 Autoren |
| 1.-2. Aug. 2026 | OpenAI | Kündigt das Modell Astra mit 10 neuen Ergebnissen und deren Lean-4-Zertifikaten an | Ohne Peer Review |
| 8. Sep. 2026 | OpenAI | Veröffentlicht einen Beweis für Existenz und Glattheit der Navier-Stokes-Gleichungen | In Prüfung, mit Streit um die Urheberschaft |
| 22. Sep. 2026 | OpenAI | Erklärt, ein internes Modell habe mehr als 100 offene Probleme gelöst | Veröffentlicht Anfang Oktober Hunderte Manuskripte |
Die Tabelle vermischt zwei verschiedene Dinge, und man sollte sie trennen. Die Erdős-Probleme sind Hunderte Fragen von sehr ungleicher Schwierigkeit, von denen sich viele kaum jemand ernsthaft angesehen hatte. Navier-Stokes ist ein Problem, an dem die besten Mathematiker jahrzehntelang gescheitert sind. Dass die ersten fallen, sagt viel über die Methode. Dass das zweite fällt, falls es sich bestätigt, sagt etwas über die rohe Leistungsfähigkeit der Modelle. Für Unternehmen ist vor allem das Erste interessant.
Warum gerade die Erdős-Probleme fallen
Paul Erdős hinterließ mehr als tausend Artikel und eine Gewohnheit: Probleme zu stellen, manchmal mit einem Preisgeld in Dollar. Thomas Bloom, heute an der University of Manchester, begann Anfang 2023 mit ein paar hundert, sie auf erdosproblems.com zu sammeln. Im August 2025 waren es fast tausend. Laut Quanta Magazine enthielt die Datenbank im August 2026 565 gelöste und 652 offene Probleme.
Quanta nennt drei Gründe, warum KI hier vorankommt und in anderen Gebieten nicht:
- Das Terrain: Die Probleme stammen vor allem aus Zahlentheorie, Kombinatorik und Graphentheorie, den Gebieten, in denen sich Sprachmodelle als am fähigsten erwiesen haben.
- Die ungleiche Schwierigkeit: Manche Probleme sind für Spezialisten trivial, andere hat nie jemand angefasst. Eine Technologie, deren Fähigkeiten ebenso ungleich verteilt sind, findet immer eines in ihrer Reichweite.
- Der öffentliche Katalog: Ein einziges, geordnetes und zugängliches Verzeichnis ist eine kostenlose Testumgebung. Jared Duker Lichtman von Stanford fasst es so zusammen: “Die Labore haben gemerkt, dass das als Benchmark funktionieren kann.”
Es gibt einen vierten, weniger auffälligen Grund. Ein Teil der “offenen” Probleme war gar nicht offen: Die Lösung war veröffentlicht, nur hatte niemand sie mit der Frage verknüpft. Problem 333 ist das extreme Beispiel. Barreto veröffentlichte am Weihnachtsmorgen einen KI-generierten Beweis, und wenige Stunden später verlinkte ein anderer Nutzer den Artikel von 1977, in dem Erdős es bereits gelöst hatte. Sein Fazit an die Community: “mehr Aufmerksamkeit für die Literaturrecherche”.
Ein Detail dazu, wer diese Arbeit macht: Barreto ist Bachelorstudent. Liam Price, mit dem er arbeitet, hat sein Studium abgebrochen. Wouter van Doorn arbeitet im Kundenservice. Price räumt laut Quanta ein, dass ihm die Ausbildung fehlt, um die Beweise, die er aus den Modellen holt, selbst zu prüfen. Was er hat, ist ein Verfahren.
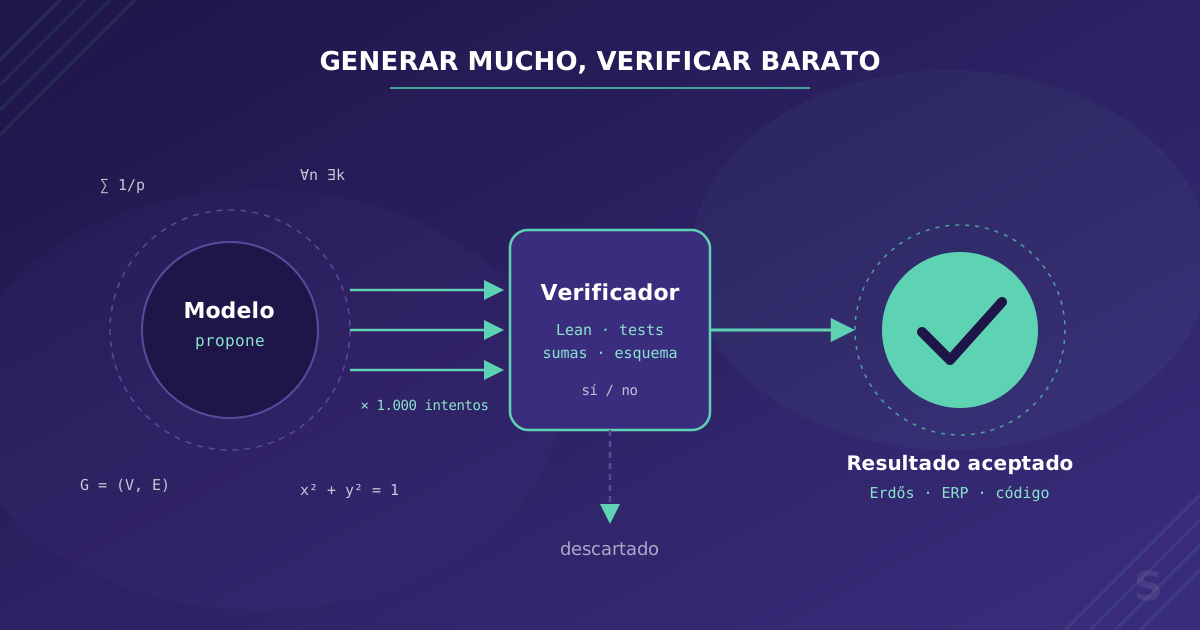
Das Muster dahinter: viel erzeugen, günstig prüfen
Prices Verfahren: Er bittet einen Chatbot um eine Lösung, gibt sie einer neuen Instanz zur Prüfung und wiederholt das. David Woodruff von der Carnegie Mellon University beschreibt dasselbe Prinzip in der Arbeit, die er mit Google an einem Problem zu Gravitationswellen gemacht hat: “Wenn ich es oft genug aufrufe, liegt es vielleicht einmal richtig.” In seinem System stellt das Modell Hypothesen auf, ein automatischer Prüfer kontrolliert die Mathematik, und ein Forscher übernimmt die abschließende Durchsicht.
Bei den belastbarsten Ergebnissen der Liste ist der Prüfer Lean, ein Beweisassistent, in dem jeder Schritt eines Beweises mechanisch kontrolliert wird. OpenAI veröffentlichte die zehn Astra-Ergebnisse mit Lean-4-Zertifikaten und null sorry, dem Wort, mit dem Lean einen Schritt markiert, der ohne Beweis als gültig angenommen wird. Damit muss niemand dem Modell vertrauen: Wenn Lean den Beweis kompiliert, ist er bezogen auf die formalisierte Aussage korrekt.
Knuths Notiz folgt demselben Schema, mit Menschen in der Rolle des Prüfers. Claude Opus 4.6 fand eine Konstruktion, um einen gerichteten Graphen in drei Hamiltonkreise zu zerlegen, wenn der Parameter ungerade ist. Filip Stappers testete sie per Computer für alle ungeraden Werte bis 101, danach schrieb Knuth den allgemeinen Beweis.
Die drei Geschichten haben dieselbe Struktur:
- Das Modell ist nicht verlässlich, und niemand behandelt es so, als wäre es das.
- Es gibt einen unabhängigen Prüfer, der ohne Interpretation Ja oder Nein sagt: Lean, ein Programm, das hundert Fälle testet, eine weitere Modellinstanz mit der Anweisung, Fehler zu suchen.
- Weil Prüfen billig ist, lassen sich viele Vorschläge erzeugen, und man behält die, die durchkommen.
Diesen Teil kann ein Unternehmen übernehmen. Die mathematischen Fähigkeiten von Astra stehen nicht zur Verfügung, und für die meisten geschäftlichen Probleme braucht man sie auch nicht.
Wo ist das “Lean” in Ihrem Unternehmen?
Die nützliche Frage bei jedem Prozess, den man mit KI automatisieren will, lautet: Was dient als Prüfer? Gibt es einen, und ist er günstig, darf das Modell neun von zehn Mal danebenliegen, und das System funktioniert trotzdem. Gibt es keinen, landet jeder Fehler beim Kunden.
| Problem | Günstiger Prüfer | Was das Modell tut |
|---|---|---|
| Daten aus einem alten ERP migrieren | Zeilenzahlen pro Tabelle, Summen der Beträge, auflösbare Fremdschlüssel | Schreibt und korrigiert die Transformationsskripte, bis alles aufgeht |
| Legacy-Code modernisieren | Die vorhandene Testsuite, der Compiler, die Typisierung | Schlägt die Änderung vor; bricht ein Test, wird sie verworfen |
| Daten aus Rechnungen oder Lieferscheinen extrahieren | Validierung gegen ein Schema, Netto + USt = Brutto, USt-IdNr. mit Prüfziffer | Liest das Dokument; was nicht aufgeht, geht an einen Menschen |
| SQL-Abfragen aus natürlicher Sprache erzeugen | Gegen ein Replikat ausführen und mit bekannten Ergebnissen vergleichen | Schlägt die Abfrage vor |
| Schichten oder Routen planen | Harte Constraints (Höchststunden, Lieferfenster) und eine Kostenfunktion | Schlägt Pläne vor oder, besser, Heuristiken, die sie erzeugen |
| Support-Antworten formulieren | Schwach: Bewertung durch ein anderes Modell anhand einer Rubrik plus menschliche Stichproben | Formuliert |
Die letzte Zeile steht dort mit Absicht. Es gibt Aufgaben ohne mechanischen Prüfer, und für sie ist Prices Technik (eine weitere Instanz prüft) das Beste, was es gibt. Ausführlich erklären wir das in LLM als Richter: Es funktioniert, muss aber am menschlichen Urteil kalibriert werden, und man muss seine Verzerrungen im Blick behalten. Je weiter oben in der Tabelle, desto mehr ähnelt das Problem einem Erdős-Problem und desto besser schneidet KI ab.
Für jeden Prozess in der linken Spalte gilt als Faustregel: Schreiben Sie den Prüfer vor dem Prompt. Ein Team, das mit dem Prompt anfängt, justiert ihn am Ende nach Gefühl anhand von fünf Beispielen. Ein Team, das mit dem Prüfer anfängt, kann an einem Nachmittag vier Modelle und zehn Prompt-Varianten testen und die behalten, die die meisten Fälle besteht.
AlphaEvolve: Wenn der Prüfer eine Kostenfunktion ist
Es gibt eine Variante des Musters für Optimierungsprobleme, bei denen es keine richtige Antwort gibt, sondern bessere und schlechtere. Google DeepMind stellte sie im Mai 2025 mit AlphaEvolve vor: ein Agent, der Programme schreibt, sie gegen einen Evaluator laufen lässt, der Punkte vergibt, und die am besten bewerteten weiterentwickelt.
In der Mathematik wandte das Team ihn später auf 67 Probleme an, erreichte die meisten bekannten Konstruktionen und verbesserte mehrere davon, unter Mitwirkung von Terence Tao und Javier Gómez-Serrano. Das erste Ergebnis, das DeepMind veröffentlichte, war aber kein mathematisches: eine Planungsheuristik für Googles Rechenzentren, die nach Angaben des Unternehmens im Schnitt 0,7 % seiner weltweiten Rechenkapazität zurückgewinnt.
Für Unternehmen ist die Form des Ergebnisses interessant. AlphaEvolve trifft nicht jede einzelne Zuweisung. Es schreibt ein kurzes, lesbares Programm, das sie trifft, und dieses Programm wird geprüft, ausgerollt und gewartet wie jedes andere. Bei Prozessen wie Tourenplanung, Schichtzuteilung oder Lagernachschub ist es genauso: Gibt es historische Daten, mit denen sich vergangene Wochen nachspielen lassen, und eine Metrik, die sagt, welcher Plan besser ist, lässt sich eine solche Schleife aufbauen, ohne das Produktivsystem anzufassen, bis ein Gewinner feststeht.
Die lange Liste der Probleme, um die sich niemand kümmert
Vor der KI waren die meisten Erdős-Probleme nicht offen, weil sie schwer waren. Sie waren offen, weil sie sich für niemanden lohnten: Ein Spezialist hätte viele davon in einer Woche lösen können, hatte aber Wichtigeres zu tun. Noga Alon aus Princeton sagte das gegenüber Quanta, als er erklärte, warum er nicht mehr daran arbeitet: “Seit die KI angefangen hat, sie zu lösen, ergibt es keinen Sinn mehr.”
Jedes Unternehmen hat seine eigene Liste von Erdős-Problemen. Die Integration, die jeden Montag von Hand mit einer Tabelle erledigt wird. Die 2.000 Produkte ohne Beschreibung. Der Bericht, den jemand jedes Quartal neu erstellt und dafür aus drei Quellen kopiert. Das Skript von 2014, das niemand anzufassen wagt. Keines davon rechtfertigt ein Projekt, und deshalb liegen sie seit Jahren im Backlog.
Was sich geändert hat, sind die Kosten pro Problem. Der Agent von DeepMind löste jedes Erdős-Problem für einige hundert US-Dollar. Die zehn Astra-Ergebnisse kosteten laut SiliconANGLE rund 2.000 US-Dollar zu API-Preisen. Am anderen Ende schätzt TechCrunch, dass der Navier-Stokes-Beweis 300 Milliarden Output-Token verbraucht hat, rund 22,5 Millionen US-Dollar zum Astra-Tarif. Die Kosten steigen mit der Schwierigkeit, und das meiste in einem Backlog liegt am günstigen Ende. Die Zahlen für jedes Modell schlüsseln wir in Was der Betrieb von LLMs in der Produktion kostet auf.
Um diese Liste zu ordnen, gilt dasselbe Kriterium wie bei den mathematischen Problemen: zuerst die mit günstigem Prüfer und geringem Einzelwert. Die hätte niemand von Hand angepackt, und ein Fehler fällt dort auf, bevor er Schaden anrichtet.
Erst suchen, dann lösen
Problem 333 hinterlässt eine nüchternere Lehre. Ein großer Teil dessen, was als “KI löst offenes Problem” gefeiert wurde, war KI, die eine bereits veröffentlichte Lösung fand. Bloom sagte das im Oktober 2025, als OpenAI behauptete, GPT-5 habe zehn Erdős-Probleme gelöst: Es handelte sich um Literaturfunde.
Das hat seinen Wert, und im Unternehmen ist es der häufigste Anwendungsfall. Die Antwort auf die Frage des Kunden steckt oft in einem PDF von 2019, in einem E-Mail-Verlauf oder im Kopf von jemandem, der nächstes Jahr in Rente geht. Ein System, das sie findet und zitiert, spart mehr Stunden als eines, das bei null anfängt zu schlussfolgern, und irrt sich seltener. Das funktioniert aber nur, wenn das Wissen an einem durchsuchbaren Ort liegt. Darum geht es in Wissensdatenbank bereit für KI.
Die praktische Reihenfolge: erst suchen, dann schlussfolgern, und immer kennzeichnen, was davon das System getan hat. Eine zitierte Antwort prüft man, indem man die Quelle öffnet. Eine erschlossene braucht einen anderen Prüfer.
Der Engpass verlagert sich in die Prüfung
Thomas Bloom in Quanta über einen der generierten Beweise: “Aber kein Mensch hat ihn gelesen, und kein Mensch wird ihn lesen. Das ist jetzt eine enorme Herausforderung.” Anfang Oktober veröffentlichte OpenAI auf einen Schlag Hunderte Manuskripte, und ein Teil der mathematischen Community reagierte mit dem Aufruf zum Boykott. Das Erzeugen ist nicht mehr der teure Teil. Das Prüfen kostet so viel wie vorher.
Im Unternehmen ist es genauso, nur in anderem Maßstab. Ein Agent, der vierzig Pull Requests am Tag öffnet oder zweihundert Produktdatenblätter pro Stunde vorschlägt, beschleunigt nichts, wenn das Team zehn davon prüfen kann. Die Änderungen stauen sich, die Prüfung wird oberflächlich, und Fehler rutschen durch.
Was funktioniert, ist eine Prüfung in Schichten:
- Automatische Verifikation von allem, was sich mechanisch prüfen lässt. Was dort scheitert, landet bei keinem Menschen.
- Bewertung durch ein anderes Modell anhand einer Rubrik für den Rest, sortiert nach Risiko.
- Menschliche Prüfung dessen, was der Bewerter als zweifelhaft markiert, plus einer Zufallsstichprobe vom Rest, um zu erkennen, ob der Bewerter abdriftet.
Beim Navier-Stokes-Beweis reicht nicht einmal das, weil das Ergebnis neu ist und niemand etwas zum Vergleichen hat. NPR brachte es in einer Schlagzeile auf den Punkt: KI hat eines der schwierigsten Probleme der Mathematik gelöst, und die Menschheit hat (vorerst) nichts gelernt. In einem Geschäftsprozess entspricht das einer Änderung, die funktioniert, ohne dass jemand im Team versteht, warum. Bei Code, den jemand warten muss, ist das eine Schuld, die später fällig wird.
Daten und Urheberschaft: Was der Navier-Stokes-Streit lehrt
Am Tag der Ankündigung veröffentlichte TechCrunch die Version von Tristan Buckmaster, Mathematiker an der NYU, der gemeinsam mit Levent Alpöge von Anthropic an dem Problem arbeitete. Buckmaster sagt, Sébastien Bubeck von OpenAI habe ihn gebeten, Alpöge die Anerkennung zu entziehen. Buckmaster hatte bei seiner Arbeit Codex verwendet, das Programmierwerkzeug von OpenAI. Laut TechCrunch heißt es in OpenAIs Veröffentlichung: “Auch wenn es unwahrscheinlich ist, können wir nicht ausschließen, dass de-identifizierte Daten aus seiner Nutzung unserer Produkte zur Verbesserung unserer Modelle beigetragen haben.”
Wie auch immer der Streit ausgeht: Der Satz gilt für jedes Unternehmen, das seinen Code, seine Verträge oder seine Kundendaten in ein KI-Werkzeug gibt. Vorher sollten Sie wissen, ob Ihr Tarif das Training mit Ihren Daten ausschließt, was gespeichert wird und wie lange, und wo die Verarbeitung stattfindet. Die Enterprise-Tarife der großen Anbieter erlauben das; kostenlose und manche bezahlte Einzeltarife nicht immer. Es ist ein Häkchen in einem Vertrag, und das sollte vor dem ersten Prompt gesetzt sein.
Hat Ihr Problem die “Form eines Erdős-Problems”?
Fünf Fragen, mit denen wir entscheiden, ob ein Prozess ein guter Kandidat für eine KI-Lösung ist, in der Reihenfolge, in der wir sie stellen:
- Gibt es einen günstigen Prüfer? Ein Test, eine Summe, die aufgehen muss, ein Schema, ein Constraint. Lässt sich nur durch den Blick eines Experten feststellen, ob das Ergebnis stimmt, taugt KI als Entwurf, nicht als System.
- Lassen sich viele Versuche erzeugen? Hat jeder Versuch Auswirkungen in der realen Welt (eine verschickte E-Mail, eine ausgelöste Bestellung), braucht es zuerst eine Umgebung, in der das nicht passiert.
- Ist es irgendwo schon gelöst? In der internen Dokumentation, in der Ticket-Historie, in der Bibliothek, die es schon gibt. Suchen ist billiger als Schlussfolgern.
- Wer prüft das Volumen, das dabei entsteht? Lautet die Antwort “dasselbe Team, das schon jetzt nicht hinterherkommt”, gehört das Design der Prüfung zum Projekt.
- Dürfen Sie Ihre Daten in das Werkzeug geben? Prüfen Sie die Nutzungsbedingungen vor dem Proof of Concept, nicht danach.
Ein Prozess, der die ersten drei Fragen gut beantwortet, ähnelt eher einem Erdős-Problem als Navier-Stokes und ist meist in wenigen Wochen umgesetzt.
Was wir damit machen
In unseren Projekten mit KI-Agenten behandeln wir die Evaluierung als eigene Disziplin: Bevor wir ein Modell wählen oder Prompts schreiben, legen wir fest, was als korrektes Ergebnis gilt und wie es sich automatisch prüfen lässt. So lassen sich Modelle anhand von Daten statt nach Eindruck vergleichen, und man weiß, ob ein Versionswechsel beim Anbieter etwas verschlechtert hat, bevor es ein Kunde merkt.
Wenn in Ihrem Backlog eine Liste von Aufgaben liegt, die niemand angeht, weil sie sich nicht lohnen, nennen Sie uns drei davon. Wir sagen Ihnen, welche einen Prüfer haben, bei welchen er erst gebaut werden muss und welche besser in Menschenhand bleiben. Schreiben Sie uns über die Seite zu künstlicher Intelligenz.