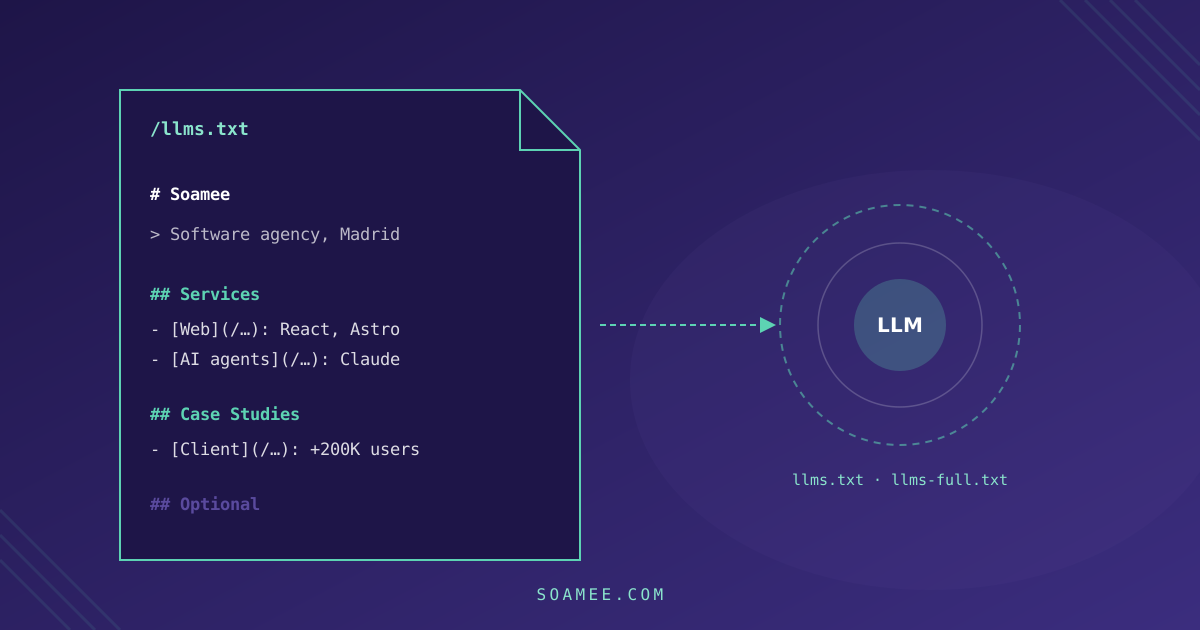
llms.txt é um arquivo Markdown publicado na raiz do domínio (seudominio.com/llms.txt) que resume para um modelo de linguagem o que é o seu site e onde está o que importa. Foi proposto por Jeremy Howard, da Answer.AI, em setembro de 2024. A especificação completa está em llmstxt.org e cabe numa tela.
Em soamee.com ele está publicado, junto com llms-full.txt e llms.json, e os três são gerados sozinhos a cada build. Aqui contamos como é o formato, o que se pode esperar dele (menos do que promete quem o vende como tática principal) e como montá-lo para que não fique desatualizado em duas semanas.
O formato
Só há um elemento obrigatório: um título # com o nome do site. Todo o resto é opcional, mas segue esta ordem:
- Título H1 com o nome do projeto ou da empresa
- Uma citação (
>) com o resumo em uma ou duas frases - Parágrafos livres com o contexto de que um modelo precisa para não errar
- Seções H2 com listas de links:
- [Nome](url): nota breve - Uma seção
## Optional, com o que pode ser descartado se o modelo estiver com pouco contexto
Um exemplo para uma empresa de serviços:
# Talleres Ruiz

> Oficina de reparação de máquinas agrícolas em Albacete desde 1994.
> Trabalhamos com tratores John Deere, New Holland e Kubota.

Atendemos Castilla-La Mancha e Múrcia. Serviço de coleta na propriedade
para avarias graves. Não vendemos máquinas novas.

## Serviços

- [Reparação de tratores](https://talleresruiz.es/reparacion): diagnóstico, motor, hidráulica e transmissão
- [Manutenção preventiva](https://talleresruiz.es/mantenimiento): revisões de 250 e 500 horas
- [Coleta na propriedade](https://talleresruiz.es/recogida): condições e áreas atendidas

## Empresa

- [Tarifas](https://talleresruiz.es/tarifas): preço por hora e deslocamento
- [Contato](https://talleresruiz.es/contacto): telefone, horário e endereço

## Optional

- [Blog](https://talleresruiz.es/blog): guias de manutenção por modelo
A frase «Não vendemos máquinas novas» parece sobrar, mas é o tipo de dado que evita que um assistente recomende você para algo que você não faz.
llms.txt e llms-full.txt
llms.txt é um índice: pouca prosa e muitos links. llms-full.txt despeja o conteúdo completo num único arquivo, para que o modelo não tenha que ir seguindo links. A proposta original fala do primeiro; o segundo é uma convenção difundida pelas plataformas de documentação técnica, onde um agente que programa precisa da referência de uma API inteira de uma vez.
Para um site de empresa, o índice é o essencial. O -full compensa se você tem conteúdo de referência (preços, especificações, perguntas frequentes) que quer que seja lido inteiro e sem interpretação.
O que faz e o que não faz
Não controla o acesso. Isso continua sendo papel do robots.txt. Se você bloqueia GPTBot ou PerplexityBot ali, ou seu firewall os barra, ninguém vai ler o llms.txt.
Não há confirmação de que melhore as citações. Nem a OpenAI, nem a Perplexity, nem o Google disseram que seus buscadores o usam para escolher fontes, e porta-vozes do Google já afirmaram em público que o buscador deles não o lê. Quem vende isso como a alavanca principal do GEO está vendendo uma hipótese.
Os agentes que chegam com uma tarefa o leem. Um agente que precisa comparar fornecedores, ou uma ferramenta de programação que precisa da documentação da sua API, procura esse arquivo porque ele poupa o rastreamento do site inteiro. É um uso menor que «aparecer no ChatGPT», e é real.
Obriga você a escrever a descrição da sua empresa para uma máquina. O que você faz, para quem, onde, desde quando e o que não faz. Esse texto é reaproveitado no markup Organization do Schema.org, nas fichas de diretórios e no bloco de resposta da home, que influenciam as citações.
Diante disso, nossa recomendação é fazê-lo, porque custa pouco, mas depois do que realmente faz diferença: rastreamento aberto aos bots de IA, HTML renderizado no servidor, respostas diretas no início de cada página e dados estruturados. Explicamos isso no guia de GEO.
Como o geramos em soamee.com
Nosso llms.txt não é um arquivo estático: é um endpoint do Astro que roda a cada build e lê as mesmas coleções de conteúdo que alimentam o blog e os casos de sucesso. Quando publicamos um caso novo, no build seguinte ele aparece no llms.txt com suas métricas públicas, sem que ninguém edite nada.
O que ele inclui:
- Dados da entidade: ano de fundação, localização, fundadores, tamanho da equipe, projetos entregues, contato
- Serviços, produtos, soluções e setores, cada um com sua URL e uma descrição de uma linha com tecnologias concretas
- Subsídios públicos na Espanha, com valores e requisitos, porque é uma pergunta que os clientes fazem aos assistentes
- Casos de sucesso com suas métricas públicas, gerados a partir do frontmatter
- Dados citados com frequência: frases curtas e verificáveis, pensadas para que um modelo possa aproveitá-las tal como estão
- Os 20 artigos mais recentes do blog, não os 300
O llms-full.txt acrescenta uma seção de perguntas e respostas e outra que associa consultas típicas («quanto custa um app na Espanha») a uma resposta direta e ao link para a página de preços. O llms.json traz o mesmo em estrutura de dados para quem prefere não fazer parse de Markdown.
A versão reduzida do endpoint:
// src/pages/llms.txt.ts
import type { APIRoute } from 'astro';
import { getCollection } from 'astro:content';

export const prerender = true;

export const GET: APIRoute = async () => {
  const cases = await getCollection('cases', (c) => !c.data.draft);

  let out = '# Soamee\n\n';
  out += '> Software development agency based in Madrid, Spain.\n\n';
  out += '## Case Studies\n\n';
  for (const c of cases) {
    const metrics = c.data.metrics.map((m) => `${m.value} ${m.label}`).join(', ');
    out += `- **${c.data.client}**: ${c.data.description} (${metrics})\n`;
  }

  return new Response(out, {
    headers: { 'Content-Type': 'text/plain; charset=utf-8' },
  });
};
Com prerender = true o arquivo é gerado como estático no build: servi-lo não custa nada e ele sempre coincide com o que está publicado. No Next.js o equivalente é um route handler em app/llms.txt/route.ts; no WordPress, um template ou um plugin que o monte a partir dos custom post types.
Para saber se alguém o lê, olhe os logs do servidor: quantas requisições /llms.txt recebe e de quais user-agents. Explicamos como em como medir o tráfego que chega do ChatGPT e de outras IAs.
Erros que o tornam inútil
Colocar o sitemap inteiro. soamee.com tem mais de 1.600 URLs publicadas. Um llms.txt com todas é um sitemap em Markdown, e o modelo não sabe quais importam. Escolha: serviços, preços, casos, contato e o mais útil do blog.
Escrevê-lo em tom de folheto. «Líderes em inovação com paixão pela excelência» não diz nada a um modelo. «Fundada em 2017 em Madri, 150+ projetos, React Native e Next.js» diz.
Fazê-lo à mão e esquecê-lo. No dia em que você muda preços, encerra um serviço ou publica um caso, o arquivo mente. Se ele não é gerado sozinho, marque uma data de revisão no calendário.
Contradizer o próprio site. Se o llms.txt diz 150 projetos e a home diz 200, um modelo que cruza fontes não sabe em qual acreditar, e pode ser que não acredite em nenhuma.
Servi-lo mal. Ele precisa responder com um 200 e text/plain ou text/markdown em UTF-8, sem redirecionamentos para a home, sem muro de cookies na frente e sem depender de JavaScript.
Checklist
-
robots.txtpermite os bots de IA que você quer (OAI-SearchBot,ChatGPT-User,PerplexityBot,Claude-User…) -
/llms.txtresponde 200, em UTF-8, sem JavaScript - H1 com o nome, citação com o resumo e um parágrafo com o que você faz e o que não faz
- Seções H2 com links selecionados, não o sitemap inteiro
- Dados que coincidem com o site e com o markup
Organization - Gerado no build, ou com data de revisão no calendário
- Requisições a
/llms.txtmonitoradas nos logs
Se quiser que o montemos junto com o resto da camada GEO do seu site, isso faz parte do nosso serviço de posicionamento em IA.