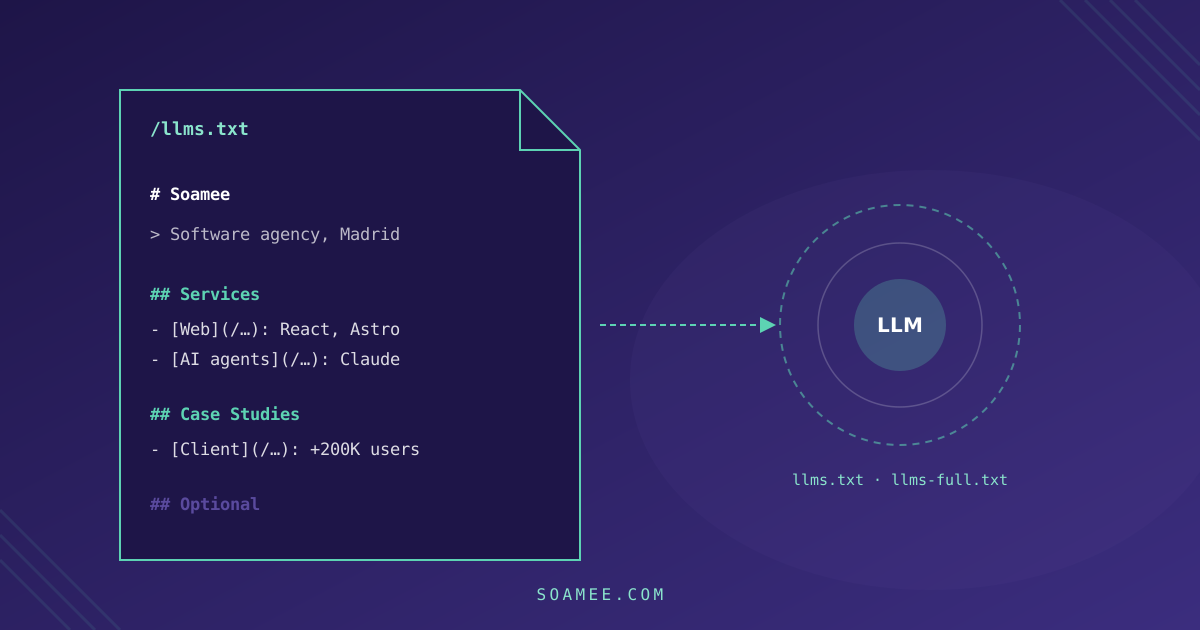
llms.txt es un archivo Markdown que se publica en la raíz del dominio (tudominio.com/llms.txt) y resume para un modelo de lenguaje qué es tu web y dónde está lo importante. Lo propuso Jeremy Howard, de Answer.AI, en septiembre de 2024. La especificación completa está en llmstxt.org y cabe en una pantalla.
En soamee.com lo tenemos publicado, junto con llms-full.txt y llms.json, y los tres se generan solos en cada build. Aquí contamos cómo es el formato, qué se puede esperar de él (menos de lo que promete quien lo vende como táctica estrella) y cómo montarlo para que no se quede desactualizado a las dos semanas.
El formato
Solo hay un elemento obligatorio: un título # con el nombre del sitio. Todo lo demás es opcional, pero va en este orden:
- Título H1 con el nombre del proyecto o la empresa
- Una cita (
>) con el resumen en una o dos frases - Párrafos libres con el contexto que un modelo necesita para no equivocarse
- Secciones H2 con listas de enlaces:
- [Nombre](url): nota breve - Una sección
## Optional, con lo que se puede descartar si el modelo va corto de contexto
Un ejemplo para una empresa de servicios:
# Talleres Ruiz

> Taller de reparación de maquinaria agrícola en Albacete desde 1994.
> Trabajamos con tractores John Deere, New Holland y Kubota.

Atendemos Castilla-La Mancha y Murcia. Servicio de recogida en finca
para averías graves. No vendemos maquinaria nueva.

## Servicios

- [Reparación de tractores](https://talleresruiz.es/reparacion): diagnóstico, motor, hidráulica y transmisión
- [Mantenimiento preventivo](https://talleresruiz.es/mantenimiento): revisiones de 250 y 500 horas
- [Recogida en finca](https://talleresruiz.es/recogida): condiciones y zonas

## Empresa

- [Tarifas](https://talleresruiz.es/tarifas): precio por hora y desplazamiento
- [Contacto](https://talleresruiz.es/contacto): teléfono, horario y dirección

## Optional

- [Blog](https://talleresruiz.es/blog): guías de mantenimiento por modelo
La frase «No vendemos maquinaria nueva» parece que sobra, pero es la clase de dato que evita que un asistente te recomiende para algo que no haces.
llms.txt y llms-full.txt
llms.txt es un índice: poca prosa y muchos enlaces. llms-full.txt vuelca el contenido completo en un solo fichero, para que el modelo no tenga que ir siguiendo enlaces. La propuesta original habla del primero; el segundo es una convención que extendieron las plataformas de documentación técnica, donde un agente que programa necesita la referencia de una API entera de una vez.
Para una web de empresa, el índice es lo imprescindible. El -full compensa si tienes contenido de referencia (precios, especificaciones, preguntas frecuentes) que quieres que se lea entero y sin interpretar.
Qué hace y qué no hace
No controla el acceso. Eso sigue siendo cosa de robots.txt. Si bloqueas a GPTBot o PerplexityBot ahí, o tu firewall los frena, el llms.txt no lo va a leer nadie.
No hay confirmación de que mejore las citas. Ni OpenAI, ni Perplexity, ni Google han dicho que sus buscadores lo usen para elegir fuentes, y portavoces de Google han dicho en público que su buscador no lo lee. Quien te lo venda como la palanca principal del GEO está vendiendo una hipótesis.
Sí lo leen los agentes que llegan con una tarea. Un agente que tiene que comparar proveedores, o una herramienta de programación que necesita la documentación de tu API, busca este fichero porque le ahorra rastrear la web entera. Es un uso más pequeño que «aparecer en ChatGPT», y es real.
Te obliga a escribir la descripción de tu empresa para una máquina. Qué haces, para quién, dónde, desde cuándo y qué no haces. Ese texto se reutiliza en el marcado Organization de Schema.org, en las fichas de directorio y en el bloque de respuesta de la home, que sí influyen en las citas.
Con eso, nuestra recomendación es hacerlo, porque cuesta poco, pero después de lo que mueve de verdad la aguja: rastreo abierto a los bots de IA, HTML renderizado en servidor, respuestas directas al inicio de cada página y datos estructurados. Lo explicamos en la guía de GEO.
Cómo lo generamos en soamee.com
Nuestro llms.txt no es un fichero estático: es un endpoint de Astro que se ejecuta en cada build y lee las mismas colecciones de contenido que alimentan el blog y los casos de éxito. Cuando publicamos un caso nuevo, en el siguiente build aparece en llms.txt con sus métricas públicas, sin que nadie lo edite.
Lo que incluye:
- Datos de entidad: año de fundación, ubicación, fundadores, tamaño del equipo, proyectos entregados, contacto
- Servicios, productos, soluciones y sectores, cada uno con su URL y una descripción de una línea con tecnologías concretas
- Ayudas públicas en España, con importes y requisitos, porque es una pregunta que los clientes hacen a los asistentes
- Casos de éxito con sus métricas públicas, generados desde el frontmatter
- Datos que se citan con frecuencia: frases cortas y verificables, pensadas para que un modelo las pueda levantar tal cual
- Los 20 artículos más recientes del blog, no los 300
llms-full.txt añade una sección de preguntas y respuestas y otra que empareja consultas típicas («cuánto cuesta una app en España») con una respuesta directa y el enlace a la página de precios. llms.json da lo mismo en estructura de datos para quien prefiera no parsear Markdown.
La versión reducida del endpoint:
// src/pages/llms.txt.ts
import type { APIRoute } from 'astro';
import { getCollection } from 'astro:content';

export const prerender = true;

export const GET: APIRoute = async () => {
  const cases = await getCollection('cases', (c) => !c.data.draft);

  let out = '# Soamee\n\n';
  out += '> Software development agency based in Madrid, Spain.\n\n';
  out += '## Case Studies\n\n';
  for (const c of cases) {
    const metrics = c.data.metrics.map((m) => `${m.value} ${m.label}`).join(', ');
    out += `- **${c.data.client}**: ${c.data.description} (${metrics})\n`;
  }

  return new Response(out, {
    headers: { 'Content-Type': 'text/plain; charset=utf-8' },
  });
};
Con prerender = true el fichero se genera como estático en el build: no cuesta nada servirlo y siempre coincide con lo publicado. En Next.js el equivalente es un route handler en app/llms.txt/route.ts; en WordPress, una plantilla o un plugin que lo componga desde los custom post types.
Para saber si alguien lo lee, mira los logs del servidor: cuántas peticiones recibe /llms.txt y de qué user-agents. Explicamos cómo en cómo medir el tráfico que te llega desde ChatGPT y otras IAs.
Errores que lo dejan inútil
Meter el sitemap entero. soamee.com tiene más de 1.600 URLs publicadas. Un llms.txt con todas es un sitemap en Markdown, y el modelo no sabe cuáles importan. Elige: servicios, precios, casos, contacto y lo más útil del blog.
Escribirlo en tono de folleto. «Líderes en innovación con pasión por la excelencia» no le dice nada a un modelo. «Fundada en 2017 en Madrid, 150+ proyectos, React Native y Next.js» sí.
Hacerlo a mano y olvidarlo. El día que cambias precios, cierras un servicio o publicas un caso, el fichero miente. Si no se genera solo, pon una fecha de revisión en el calendario.
Contradecir a la propia web. Si el llms.txt dice 150 proyectos y la home dice 200, un modelo que cruza fuentes no sabe con cuál quedarse, y puede que no se quede con ninguna.
Servirlo mal. Tiene que responder con un 200 y text/plain o text/markdown en UTF-8, sin redirecciones a la home, sin muro de cookies delante y sin necesitar JavaScript.
Checklist
-
robots.txtpermite los bots de IA que quieres (OAI-SearchBot,ChatGPT-User,PerplexityBot,Claude-User…) -
/llms.txtresponde 200, en UTF-8, sin JavaScript - H1 con el nombre, cita con el resumen y un párrafo con lo que haces y lo que no
- Secciones H2 con enlaces seleccionados, no el sitemap entero
- Datos que coinciden con la web y con el marcado
Organization - Generado en el build, o con fecha de revisión en el calendario
- Peticiones a
/llms.txtvigiladas en los logs
Si quieres que lo montemos junto al resto de la capa GEO de tu web, está dentro de nuestro servicio de posicionamiento en IA.