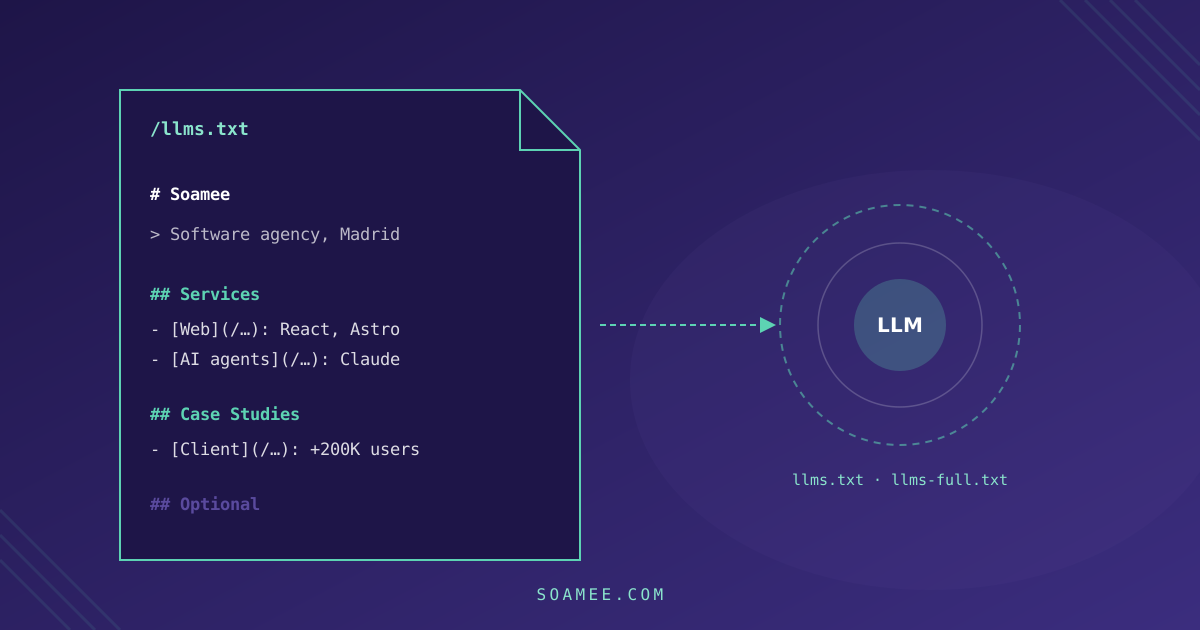
llms.txt è un file Markdown che si pubblica nella radice del dominio (tuodominio.com/llms.txt) e riassume per un modello linguistico cos’è il tuo sito e dove si trovano le cose importanti. Lo ha proposto Jeremy Howard, di Answer.AI, nel settembre 2024. La specifica completa è su llmstxt.org e sta in una schermata.
Su soamee.com lo abbiamo pubblicato, insieme a llms-full.txt e llms.json, e tutti e tre si generano da soli a ogni build. Qui spieghiamo com’è fatto il formato, cosa ci si può aspettare (meno di quanto prometta chi lo vende come tattica di punta) e come impostarlo perché non resti obsoleto dopo due settimane.
Il formato
C’è un solo elemento obbligatorio: un titolo # con il nome del sito. Tutto il resto è facoltativo, ma va in quest’ordine:
- Titolo H1 con il nome del progetto o dell’azienda
- Una citazione (
>) con il riassunto in una o due frasi - Paragrafi liberi con il contesto che serve a un modello per non sbagliare
- Sezioni H2 con elenchi di link:
- [Nome](url): nota breve - Una sezione
## Optional, con ciò che si può scartare se il modello ha poco contesto a disposizione
Un esempio per un’azienda di servizi:
# Talleres Ruiz

> Officina di riparazione di macchine agricole ad Albacete dal 1994.
> Lavoriamo con trattori John Deere, New Holland e Kubota.

Serviamo Castilla-La Mancha e Murcia. Servizio di ritiro in azienda agricola
per guasti gravi. Non vendiamo macchinari nuovi.

## Servizi

- [Riparazione trattori](https://talleresruiz.es/reparacion): diagnosi, motore, idraulica e trasmissione
- [Manutenzione preventiva](https://talleresruiz.es/mantenimiento): tagliandi da 250 e 500 ore
- [Ritiro in azienda](https://talleresruiz.es/recogida): condizioni e zone

## Azienda

- [Tariffe](https://talleresruiz.es/tarifas): prezzo orario e trasferta
- [Contatti](https://talleresruiz.es/contacto): telefono, orari e indirizzo

## Optional

- [Blog](https://talleresruiz.es/blog): guide di manutenzione per modello
La frase «Non vendiamo macchinari nuovi» sembra superflua, ma è il tipo di dato che evita che un assistente ti consigli per qualcosa che non fai.
llms.txt e llms-full.txt
llms.txt è un indice: poca prosa e molti link. llms-full.txt riversa il contenuto completo in un solo file, così il modello non deve seguire i link uno per uno. La proposta originale parla del primo; il secondo è una convenzione diffusa dalle piattaforme di documentazione tecnica, dove un agente che programma ha bisogno di tutto il riferimento di un’API in una volta.
Per il sito di un’azienda, l’indice è l’indispensabile. Il -full conviene se hai contenuti di riferimento (prezzi, specifiche, domande frequenti) che vuoi vengano letti per intero e senza interpretazioni.
Cosa fa e cosa non fa
Non controlla l’accesso. Quello resta compito di robots.txt. Se lì blocchi GPTBot o PerplexityBot, o il tuo firewall li ferma, il llms.txt non lo leggerà nessuno.
Non c’è conferma che migliori le citazioni. Né OpenAI, né Perplexity, né Google hanno detto che i loro motori di ricerca lo usano per scegliere le fonti, e portavoce di Google hanno dichiarato pubblicamente che il loro motore non lo legge. Chi te lo vende come la leva principale della GEO sta vendendo un’ipotesi.
Lo leggono gli agenti che arrivano con un compito. Un agente che deve confrontare fornitori, o uno strumento di programmazione che ha bisogno della documentazione della tua API, cerca questo file perché gli evita di scansionare l’intero sito. È un uso più ristretto di «comparire su ChatGPT», ed è reale.
Ti obbliga a scrivere la descrizione della tua azienda per una macchina. Cosa fai, per chi, dove, da quando e cosa non fai. Quel testo si riutilizza nel markup Organization di Schema.org, nelle schede delle directory e nel blocco di risposta della home, che invece influiscono sulle citazioni.
Detto questo, il nostro consiglio è farlo, perché costa poco, ma dopo ciò che sposta davvero l’ago: scansione aperta ai bot di IA, HTML renderizzato lato server, risposte dirette all’inizio di ogni pagina e dati strutturati. Lo spieghiamo nella guida alla GEO.
Come lo generiamo su soamee.com
Il nostro llms.txt non è un file statico: è un endpoint di Astro che si esegue a ogni build e legge le stesse collezioni di contenuti che alimentano il blog e i casi di successo. Quando pubblichiamo un nuovo caso, alla build successiva compare in llms.txt con le sue metriche pubbliche, senza che nessuno lo modifichi.
Cosa include:
- Dati di entità: anno di fondazione, sede, fondatori, dimensione del team, progetti consegnati, contatti
- Servizi, prodotti, soluzioni e settori, ciascuno con il suo URL e una descrizione di una riga con tecnologie concrete
- Agevolazioni pubbliche in Spagna, con importi e requisiti, perché è una domanda che i clienti fanno agli assistenti
- Casi di successo con le loro metriche pubbliche, generati dal frontmatter
- Dati citati spesso: frasi brevi e verificabili, pensate perché un modello possa riprenderle così come sono
- I 20 articoli più recenti del blog, non i 300
llms-full.txt aggiunge una sezione di domande e risposte e un’altra che abbina query tipiche («quanto costa un’app in Spagna») a una risposta diretta e al link alla pagina dei prezzi. llms.json fornisce lo stesso come struttura dati per chi preferisce non fare il parsing del Markdown.
La versione ridotta dell’endpoint:
// src/pages/llms.txt.ts
import type { APIRoute } from 'astro';
import { getCollection } from 'astro:content';

export const prerender = true;

export const GET: APIRoute = async () => {
  const cases = await getCollection('cases', (c) => !c.data.draft);

  let out = '# Soamee\n\n';
  out += '> Software development agency based in Madrid, Spain.\n\n';
  out += '## Case Studies\n\n';
  for (const c of cases) {
    const metrics = c.data.metrics.map((m) => `${m.value} ${m.label}`).join(', ');
    out += `- **${c.data.client}**: ${c.data.description} (${metrics})\n`;
  }

  return new Response(out, {
    headers: { 'Content-Type': 'text/plain; charset=utf-8' },
  });
};
Con prerender = true il file viene generato come statico durante la build: servirlo non costa nulla e coincide sempre con ciò che è pubblicato. In Next.js l’equivalente è un route handler in app/llms.txt/route.ts; in WordPress, un template o un plugin che lo componga a partire dai custom post type.
Per sapere se qualcuno lo legge, guarda i log del server: quante richieste riceve /llms.txt e da quali user-agent. Spieghiamo come in come misurare il traffico da ChatGPT e dalle altre IA.
Errori che lo rendono inutile
Metterci tutta la sitemap. soamee.com ha più di 1.600 URL pubblicati. Un llms.txt che li contiene tutti è una sitemap in Markdown, e il modello non sa quali contano. Scegli: servizi, prezzi, casi, contatti e il meglio del blog.
Scriverlo con il tono di una brochure. «Leader nell’innovazione con la passione per l’eccellenza» non dice nulla a un modello. «Fondata nel 2017 a Madrid, 150+ progetti, React Native e Next.js» sì.
Farlo a mano e dimenticarlo. Il giorno in cui cambi i prezzi, chiudi un servizio o pubblichi un caso, il file mente. Se non si genera da solo, metti una data di revisione in calendario.
Contraddire il proprio sito. Se il llms.txt dice 150 progetti e la home dice 200, un modello che incrocia le fonti non sa quale scegliere, e potrebbe non sceglierne nessuna.
Servirlo male. Deve rispondere con un 200 e text/plain o text/markdown in UTF-8, senza redirect alla home, senza un muro di cookie davanti e senza bisogno di JavaScript.
Checklist
-
robots.txtconsente i bot di IA che vuoi (OAI-SearchBot,ChatGPT-User,PerplexityBot,Claude-User…) -
/llms.txtrisponde 200, in UTF-8, senza JavaScript - H1 con il nome, citazione con il riassunto e un paragrafo con ciò che fai e ciò che non fai
- Sezioni H2 con link selezionati, non l’intera sitemap
- Dati coerenti con il sito e con il markup
Organization - Generato nella build, o con una data di revisione in calendario
- Richieste a
/llms.txtmonitorate nei log
Se vuoi che lo impostiamo insieme al resto del livello GEO del tuo sito, rientra nel nostro servizio di posizionamento nelle IA.