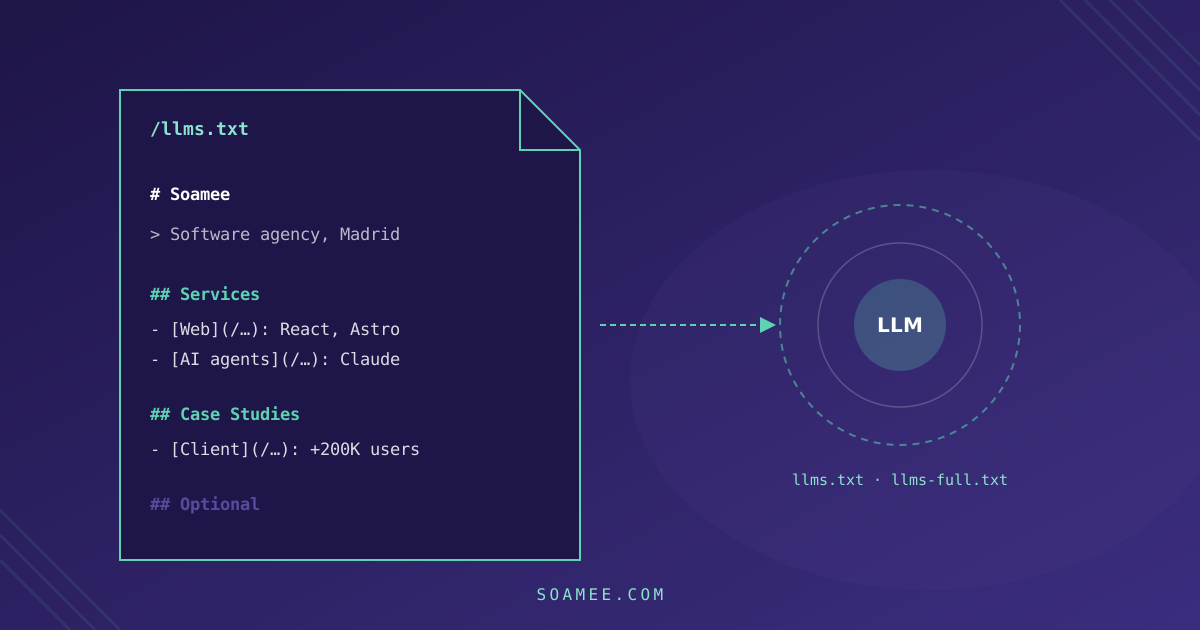
llms.txt ist eine Markdown-Datei, die im Stammverzeichnis der Domain liegt (ihredomain.de/llms.txt) und einem Sprachmodell zusammenfasst, worum es auf Ihrer Website geht und wo das Wichtige steht. Vorgeschlagen hat sie Jeremy Howard von Answer.AI im September 2024. Die vollständige Spezifikation steht auf llmstxt.org und passt auf einen Bildschirm.
Auf soamee.com ist sie veröffentlicht, zusammen mit llms-full.txt und llms.json, und alle drei entstehen automatisch bei jedem Build. Hier beschreiben wir das Format, was man davon erwarten kann (weniger, als diejenigen versprechen, die es als Wundertaktik verkaufen) und wie man es so aufsetzt, dass es nicht nach zwei Wochen veraltet ist.
Das Format
Pflicht ist nur ein Element: eine Überschrift # mit dem Namen der Website. Alles andere ist optional, folgt aber dieser Reihenfolge:
- H1-Überschrift mit dem Namen des Projekts oder Unternehmens
- Ein Zitatblock (
>) mit der Zusammenfassung in ein oder zwei Sätzen - Freie Absätze mit dem Kontext, den ein Modell braucht, um sich nicht zu irren
- H2-Abschnitte mit Linklisten:
- [Name](url): kurze Notiz - Ein Abschnitt
## Optionalmit dem, was wegfallen kann, wenn der Kontext des Modells knapp wird
Ein Beispiel für einen Dienstleister:
# Talleres Ruiz

> Werkstatt für Landmaschinenreparatur in Albacete seit 1994.
> Wir arbeiten mit Traktoren von John Deere, New Holland und Kubota.

Wir betreuen Kastilien-La Mancha und Murcia. Abholservice direkt vom Hof
bei schweren Schäden. Wir verkaufen keine Neumaschinen.

## Leistungen

- [Traktorreparatur](https://talleresruiz.es/reparacion): Diagnose, Motor, Hydraulik und Getriebe
- [Vorbeugende Wartung](https://talleresruiz.es/mantenimiento): Inspektionen nach 250 und 500 Betriebsstunden
- [Abholung vom Hof](https://talleresruiz.es/recogida): Bedingungen und Gebiete

## Unternehmen

- [Preise](https://talleresruiz.es/tarifas): Stundensatz und Anfahrt
- [Kontakt](https://talleresruiz.es/contacto): Telefon, Öffnungszeiten und Adresse

## Optional

- [Blog](https://talleresruiz.es/blog): Wartungsanleitungen nach Modell
Der Satz „Wir verkaufen keine Neumaschinen“ wirkt überflüssig, ist aber genau die Art von Angabe, die verhindert, dass ein Assistent Sie für etwas empfiehlt, das Sie gar nicht anbieten.
llms.txt und llms-full.txt
llms.txt ist ein Index: wenig Fließtext, viele Links. llms-full.txt legt den vollständigen Inhalt in einer einzigen Datei ab, damit das Modell nicht Link für Link folgen muss. Der ursprüngliche Vorschlag behandelt die erste Datei; die zweite ist eine Konvention, die Plattformen für technische Dokumentation verbreitet haben, wo ein programmierender Agent die Referenz einer ganzen API auf einmal braucht.
Für eine Unternehmenswebsite ist der Index das Unverzichtbare. Die -full-Variante lohnt sich, wenn Sie Referenzinhalte haben (Preise, Spezifikationen, häufige Fragen), die vollständig und ohne Interpretation gelesen werden sollen.
Was sie leistet und was nicht
Sie steuert keinen Zugriff. Das bleibt Aufgabe der robots.txt. Wenn Sie GPTBot oder PerplexityBot dort sperren oder Ihre Firewall sie ausbremst, liest niemand die llms.txt.
Es gibt keine Bestätigung, dass sie Zitate verbessert. Weder OpenAI noch Perplexity noch Google haben erklärt, dass ihre Suchsysteme sie zur Auswahl von Quellen nutzen, und Google-Sprecher haben öffentlich gesagt, dass ihre Suchmaschine sie nicht liest. Wer sie Ihnen als wichtigsten GEO-Hebel verkauft, verkauft eine Hypothese.
Agenten, die mit einer Aufgabe kommen, lesen sie. Ein Agent, der Anbieter vergleichen soll, oder ein Programmierwerkzeug, das die Dokumentation Ihrer API braucht, sucht nach dieser Datei, weil sie ihm das Crawlen der ganzen Website erspart. Dieser Nutzen ist kleiner als „in ChatGPT erscheinen“, aber er ist real.
Sie zwingt Sie, die Beschreibung Ihres Unternehmens für eine Maschine zu schreiben. Was Sie tun, für wen, wo, seit wann und was Sie nicht tun. Dieser Text lässt sich im Organization-Markup von Schema.org, in Verzeichniseinträgen und im Antwortblock der Startseite wiederverwenden, und diese beeinflussen Zitate tatsächlich.
Deshalb empfehlen wir, sie anzulegen, weil es wenig kostet, aber erst nach dem, was wirklich etwas bewegt: Crawling für KI-Bots offen, serverseitig gerendertes HTML, direkte Antworten am Anfang jeder Seite und strukturierte Daten. Wir erklären das im GEO-Leitfaden.
Wie wir sie auf soamee.com erzeugen
Unsere llms.txt ist keine statische Datei, sondern ein Astro-Endpoint, der bei jedem Build läuft und dieselben Content Collections liest, aus denen Blog und Fallstudien gespeist werden. Wenn wir eine neue Fallstudie veröffentlichen, erscheint sie beim nächsten Build mit ihren öffentlichen Kennzahlen in der llms.txt, ohne dass jemand die Datei bearbeitet.
Was sie enthält:
- Unternehmensdaten: Gründungsjahr, Standort, Gründer, Teamgröße, abgeschlossene Projekte, Kontakt
- Dienstleistungen, Produkte, Lösungen und Branchen, jeweils mit URL und einer einzeiligen Beschreibung mit konkreten Technologien
- Öffentliche Förderprogramme in Spanien, mit Beträgen und Voraussetzungen, weil Kunden Assistenten genau danach fragen
- Fallstudien mit ihren öffentlichen Kennzahlen, erzeugt aus dem Frontmatter
- Häufig zitierte Fakten: kurze, überprüfbare Sätze, die ein Modell unverändert übernehmen kann
- Die 20 neuesten Artikel aus dem Blog, nicht alle 300
llms-full.txt ergänzt einen Abschnitt mit Fragen und Antworten und einen weiteren, der typische Suchanfragen („was kostet eine App in Spanien“) mit einer direkten Antwort und dem Link zur Preisseite verknüpft. llms.json liefert dasselbe als Datenstruktur für alle, die kein Markdown parsen wollen.
Die gekürzte Version des Endpoints:
// src/pages/llms.txt.ts
import type { APIRoute } from 'astro';
import { getCollection } from 'astro:content';

export const prerender = true;

export const GET: APIRoute = async () => {
  const cases = await getCollection('cases', (c) => !c.data.draft);

  let out = '# Soamee\n\n';
  out += '> Software development agency based in Madrid, Spain.\n\n';
  out += '## Case Studies\n\n';
  for (const c of cases) {
    const metrics = c.data.metrics.map((m) => `${m.value} ${m.label}`).join(', ');
    out += `- **${c.data.client}**: ${c.data.description} (${metrics})\n`;
  }

  return new Response(out, {
    headers: { 'Content-Type': 'text/plain; charset=utf-8' },
  });
};
Mit prerender = true wird die Datei beim Build als statische Datei erzeugt: Das Ausliefern kostet nichts, und sie stimmt immer mit dem Veröffentlichten überein. In Next.js ist das Gegenstück ein Route Handler unter app/llms.txt/route.ts; in WordPress ein Template oder ein Plugin, das die Datei aus den Custom Post Types zusammensetzt.
Ob jemand sie liest, zeigen die Serverlogs: wie viele Anfragen /llms.txt erhält und von welchen User-Agents. Wie das geht, erklären wir in Traffic aus ChatGPT und anderen KIs messen.
Fehler, die sie nutzlos machen
Die ganze Sitemap hineinpacken. soamee.com hat mehr als 1.600 veröffentlichte URLs. Eine llms.txt mit allen ist eine Sitemap in Markdown, und das Modell weiß nicht, welche zählen. Wählen Sie aus: Leistungen, Preise, Fallstudien, Kontakt und das Nützlichste aus dem Blog.
Sie im Prospektton schreiben. „Führend in Innovation mit Leidenschaft für Exzellenz“ sagt einem Modell nichts. „Gegründet 2017 in Madrid, 150+ Projekte, React Native und Next.js“ schon.
Sie von Hand anlegen und vergessen. An dem Tag, an dem Sie Preise ändern, eine Leistung einstellen oder eine Fallstudie veröffentlichen, lügt die Datei. Wenn sie nicht automatisch entsteht, tragen Sie einen Prüftermin in den Kalender ein.
Der eigenen Website widersprechen. Wenn die llms.txt 150 Projekte nennt und die Startseite 200, weiß ein Modell, das Quellen abgleicht, nicht, welcher Angabe es folgen soll, und folgt womöglich keiner.
Sie falsch ausliefern. Sie muss mit 200 und text/plain oder text/markdown in UTF-8 antworten, ohne Weiterleitung auf die Startseite, ohne Cookie-Wall davor und ohne JavaScript zu benötigen.
Checkliste
-
robots.txterlaubt die KI-Bots, die Sie zulassen wollen (OAI-SearchBot,ChatGPT-User,PerplexityBot,Claude-User…) -
/llms.txtantwortet mit 200, in UTF-8, ohne JavaScript - H1 mit dem Namen, Zitatblock mit der Zusammenfassung und ein Absatz dazu, was Sie tun und was nicht
- H2-Abschnitte mit ausgewählten Links, nicht die ganze Sitemap
- Angaben, die mit der Website und dem
Organization-Markup übereinstimmen - Beim Build erzeugt oder mit Prüftermin im Kalender
- Anfragen an
/llms.txtin den Logs beobachtet
Wenn wir sie zusammen mit der übrigen GEO-Ebene Ihrer Website aufsetzen sollen: Das gehört zu unserem Service für KI-Sichtbarkeit.