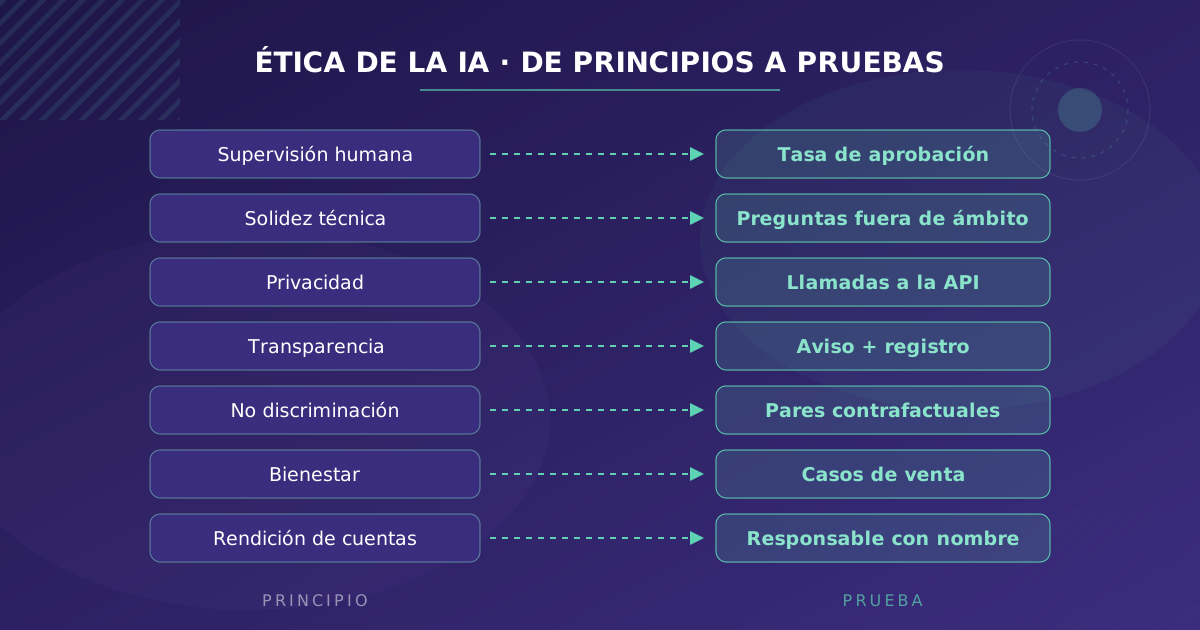
En 2019, tres investigadores de la ETH de Zúrich reunieron todas las guías de ética de la IA que encontraron publicadas por empresas, gobiernos y organizaciones. Contaron 84 documentos. Los principios que más se repetían eran cinco: transparencia, justicia, no hacer daño, responsabilidad y privacidad. Desde entonces la lista ha crecido, y muchas empresas medianas tienen ya su propia página de “principios de IA responsable”.
Esa página no dice si tu chatbot trata igual a una clienta llamada Lucía que a una llamada Fátima. Para saberlo hay que mandarle las dos conversaciones y comparar las respuestas. Este post va de ese paso: cómo pasar de un principio a una prueba que se pueda ejecutar, medir y repetir.
Por qué los principios no bastan
El mismo año, el filósofo Brent Mittelstadt publicó un artículo con un título que lo resume todo: Principles alone cannot guarantee ethical AI. Su argumento compara la IA con la medicina, que es de donde viene el enfoque de principios (autonomía, beneficencia, no maleficencia, justicia). En medicina los principios funcionan porque detrás hay cuatro cosas que en el desarrollo de software no existen:
- Un fin compartido. El médico trabaja para la salud del paciente. Un equipo de producto trabaja para la empresa, y los intereses del usuario a veces coinciden y a veces no.
- Una profesión con historia. Siglos de casos, normas deontológicas y colegios profesionales que interpretan qué significa “no hacer daño” en cada situación.
- Métodos para bajar del principio al caso. Comités de ética, protocolos clínicos, consentimiento informado.
- Consecuencias por incumplir. Un médico puede perder la licencia. Un desarrollador que publica un modelo sesgado, de momento, no.
La conclusión práctica para una empresa es que el principio solo hace algo cuando alguien lo convierte en una prueba con un umbral y le pone un responsable.
Los siete requisitos europeos y la prueba que corresponde a cada uno
El grupo de expertos de alto nivel de la Comisión Europea publicó en 2019 siete requisitos para una IA fiable. Son el antecedente directo del AI Act, así que tiene sentido partir de ellos. Esta es la traducción que usamos para un sistema típico de empresa, como un chatbot de atención al cliente o un asistente que ordena solicitudes:
| Requisito | Pregunta concreta | Prueba |
|---|---|---|
| Acción y supervisión humanas | ¿Puede una persona revisar y anular lo que decide el sistema? ¿Lo hace de verdad? | Medir la tasa de aprobación y el tiempo por revisión de quien supervisa |
| Solidez técnica y seguridad | ¿Qué hace el sistema con preguntas fuera de su ámbito o con intentos de manipularlo? | Batería de preguntas fuera de ámbito y de inyección de instrucciones |
| Privacidad y gestión de datos | ¿Qué datos personales salen hacia el proveedor del modelo y dónde se procesan? | Revisión de las llamadas a la API y del contrato de tratamiento de datos |
| Transparencia | ¿Sabe el usuario que habla con una IA? ¿Se puede reconstruir por qué respondió algo? | Comprobar el aviso en la primera respuesta y que cada respuesta quede registrada con su contexto |
| Diversidad y no discriminación | ¿Cambia la respuesta si cambia el nombre, el género o la edad del usuario? | Pruebas contrafactuales: pares de conversaciones idénticas salvo en ese dato |
| Bienestar social y ambiental | ¿Empuja el sistema a decisiones que perjudican al usuario? | Revisión de los casos en los que el sistema recomienda o vende |
| Rendición de cuentas | ¿Quién responde si el sistema se equivoca? ¿Puede el usuario reclamar? | Un responsable con nombre por sistema y un canal de reclamación que llegue a una persona |
Ninguna de estas pruebas necesita un equipo de investigación. Las contrafactuales, por ejemplo, son la misma idea que usaron Bertrand y Mullainathan en 2004 para medir discriminación en la contratación: mandaron currículums idénticos con nombres distintos y contaron cuántos recibían llamada. Con un modelo de lenguaje se puede hacer lo mismo con cientos de pares en una tarde, y evaluar las diferencias de tono con un LLM como juez calibrado contra revisión humana.
Cuando dos principios chocan
La parte que más se esquiva en los códigos éticos es que los principios entran en conflicto, y ahí es donde la ética deja de ser una lista y pasa a ser una decisión.
Equidad contra equidad. En 2016, ProPublica analizó COMPAS, un sistema que puntúa el riesgo de reincidencia en Estados Unidos, y encontró que se equivocaba más con los acusados negros clasificándolos como de alto riesgo. La empresa respondió que el sistema estaba igual de bien calibrado para los dos grupos: una misma puntuación significaba la misma probabilidad de reincidir. Las dos cosas eran ciertas a la vez. Ese mismo año, Kleinberg, Mullainathan y Raghavan demostraron que, salvo en casos excepcionales, es matemáticamente imposible cumplir a la vez las dos definiciones de equidad cuando los grupos tienen tasas base distintas. Hay que elegir cuál importa más en tu caso, y esa elección no la puede tomar el modelo.
Transparencia contra privacidad. Para poder explicar por qué el sistema dijo algo hay que guardar la conversación entera con su contexto. Para minimizar datos personales, como pide el RGPD, conviene guardar lo menos posible. La salida habitual es guardar todo durante un periodo corto, seudonimizado, y conservar más tiempo solo los casos marcados como incidencia. Es un compromiso, y hay que escribirlo como tal.
Supervisión humana contra coste. Revisar cada decisión de un sistema elimina buena parte del ahorro que justificaba automatizar. Revisar una muestra es más barato, pero deja decisiones sin revisar. La pregunta útil es qué decisiones no pueden quedar sin revisión (descartar a un candidato, denegar un servicio) y cuáles sí (clasificar un ticket).
En los tres casos lo exigible a una empresa es lo mismo: decidir de forma explícita, escribir el motivo y poner el nombre de quien lo decidió. Esto es lo que Mittelstadt echaba en falta: un método para bajar del principio al caso, aunque sea modesto.
Qué parte es obligatoria
El AI Act convirtió en ley una parte de esos siete requisitos, con fechas distintas:
- Desde agosto de 2026, cualquier chatbot tiene que informar de que es una IA y el contenido sintético tiene que ir marcado (artículo 50).
- Desde diciembre de 2027, tras el retraso que introdujo el Ómnibus Digital, los sistemas de alto riesgo (selección de personal, crédito, seguros, educación, servicios esenciales) necesitan gestión de riesgos, datos de calidad, registros, supervisión humana y, en algunos casos, una evaluación de impacto en derechos fundamentales.
Lo explicamos con más detalle en nuestra guía del AI Act. El resto de los requisitos, como el bienestar del usuario o qué hacer cuando la equidad choca consigo misma, queda fuera de la ley para la mayoría de sistemas y depende de lo que decida cada empresa.
Por dónde empezar en una pyme
- Haz inventario. Apunta cada sistema de IA que se usa en la empresa, incluidas las funciones de IA del CRM, el ATS o el helpdesk. Suele haber más de los que dirección cree.
- Elige un sistema que afecte a personas y escribe tres preguntas de la tabla de arriba que le apliquen.
- Convierte cada pregunta en una prueba con un umbral. Por ejemplo: “en 200 pares de conversaciones que solo cambian el nombre, la diferencia en la tasa de respuestas que ofrecen una solución no supera los dos puntos”.
- Lánzala, guarda el resultado y repítela cada vez que cambies de modelo o de prompt. El comportamiento de un LLM cambia con cada versión, y una prueba que pasó en marzo no dice nada de la versión de junio.
- Documenta los conflictos que aparezcan y quién decidió qué.
Si prefieres que lo hagamos nosotros, hacemos auditorías de IA responsable: inventario, baterías de pruebas sobre los sistemas que importan e informe con un plan de acción que sirva a tu equipo técnico y a tu asesor legal.