2019 haben drei Forschende der ETH Zürich alle KI-Ethik-Leitlinien gesammelt, die sie von Unternehmen, Regierungen und Organisationen finden konnten. Sie kamen auf 84 Dokumente. Fünf Prinzipien tauchten am häufigsten auf: Transparenz, Gerechtigkeit, Schadensvermeidung, Verantwortung und Privatsphäre. Seitdem ist die Liste gewachsen, und viele mittelständische Unternehmen haben inzwischen ihre eigene Seite mit “Grundsätzen für verantwortungsvolle KI”.
Diese Seite sagt Ihnen nicht, ob Ihr Chatbot eine Kundin namens Lucía genauso behandelt wie eine namens Fátima. Um das herauszufinden, müssen Sie ihm beide Gespräche schicken und die Antworten vergleichen. Um diesen Schritt geht es in diesem Beitrag: wie aus einem Prinzip ein Test wird, den man ausführen, messen und wiederholen kann.
Warum Prinzipien nicht ausreichen
Im selben Jahr veröffentlichte der Philosoph Brent Mittelstadt einen Aufsatz, dessen Titel alles zusammenfasst: Principles alone cannot guarantee ethical AI. Er vergleicht KI mit der Medizin, aus der der prinzipienbasierte Ansatz stammt (Autonomie, Fürsorge, Nichtschaden, Gerechtigkeit). In der Medizin funktionieren Prinzipien, weil vier Dinge dahinterstehen, die es in der Softwareentwicklung nicht gibt:
- Ein gemeinsames Ziel. Die Ärztin arbeitet für die Gesundheit des Patienten. Ein Produktteam arbeitet für das Unternehmen, und die Interessen der Nutzer decken sich damit manchmal und manchmal nicht.
- Ein Berufsstand mit Geschichte. Jahrhunderte an Fällen, Berufsordnungen und Kammern, die auslegen, was “nicht schaden” in jeder Situation bedeutet.
- Methoden, um vom Prinzip zum Einzelfall zu kommen. Ethikkommissionen, klinische Protokolle, informierte Einwilligung.
- Konsequenzen bei Verstößen. Ein Arzt kann seine Approbation verlieren. Ein Entwickler, der ein verzerrtes Modell veröffentlicht, vorerst nicht.
Die praktische Schlussfolgerung für ein Unternehmen: Ein Prinzip bewirkt erst dann etwas, wenn jemand daraus einen Test mit einem Schwellenwert macht und einen Verantwortlichen dafür benennt.
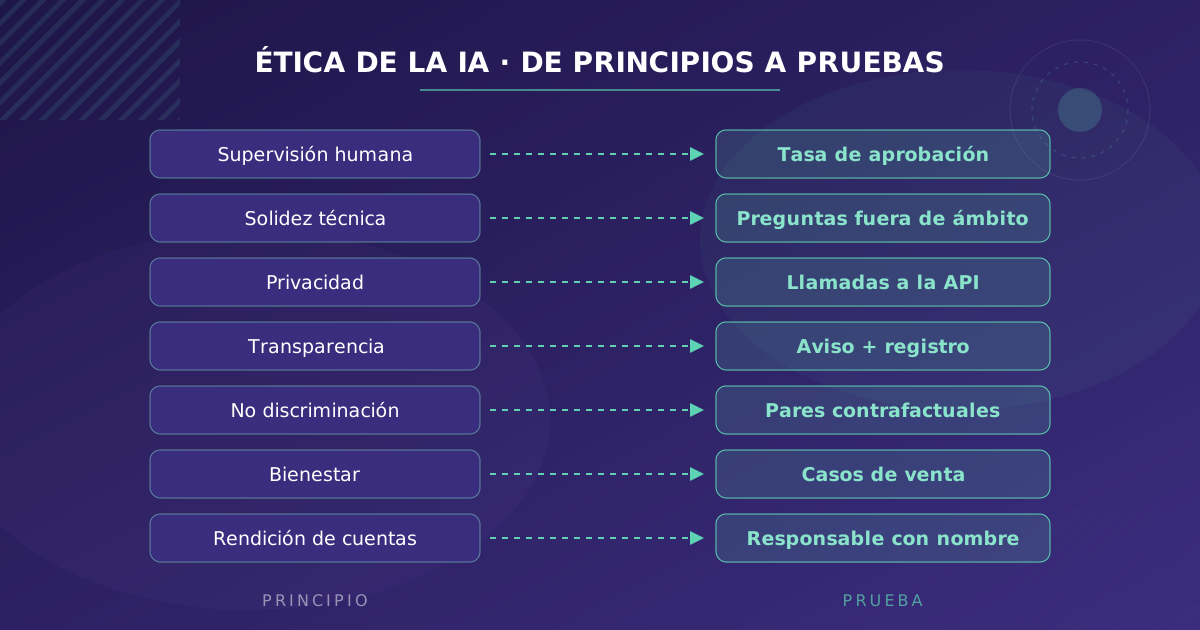
Die sieben europäischen Anforderungen und der passende Test
Die Hochrangige Expertengruppe der Europäischen Kommission hat 2019 sieben Anforderungen an vertrauenswürdige KI veröffentlicht. Sie sind der direkte Vorläufer der KI-Verordnung, deshalb ist es sinnvoll, bei ihnen anzusetzen. So übersetzen wir sie für ein typisches Unternehmenssystem, etwa einen Kundenservice-Chatbot oder einen Assistenten, der Anfragen sortiert:
| Anforderung | Konkrete Frage | Test |
|---|---|---|
| Vorrang menschlichen Handelns und menschliche Aufsicht | Kann ein Mensch prüfen und aufheben, was das System entscheidet? Tut er es tatsächlich? | Freigabequote und Zeit pro Prüfung der aufsichtführenden Person messen |
| Technische Robustheit und Sicherheit | Was macht das System mit Fragen außerhalb seines Bereichs oder mit Manipulationsversuchen? | Testreihe mit themenfremden Fragen und Prompt-Injection-Versuchen |
| Schutz der Privatsphäre und Datenqualitätsmanagement | Welche personenbezogenen Daten gehen an den Modellanbieter, und wo werden sie verarbeitet? | Prüfung der API-Aufrufe und des Auftragsverarbeitungsvertrags |
| Transparenz | Weiß der Nutzer, dass er mit einer KI spricht? Lässt sich nachvollziehen, warum sie etwas geantwortet hat? | Hinweis in der ersten Antwort prüfen, ebenso, dass jede Antwort mit ihrem Kontext protokolliert wird |
| Vielfalt und Nichtdiskriminierung | Ändert sich die Antwort, wenn sich Name, Geschlecht oder Alter des Nutzers ändern? | Kontrafaktische Tests: Gesprächspaare, die bis auf dieses eine Merkmal identisch sind |
| Gesellschaftliches und ökologisches Wohlergehen | Drängt das System Nutzer zu Entscheidungen, die ihnen schaden? | Prüfung der Fälle, in denen das System etwas empfiehlt oder verkauft |
| Rechenschaftspflicht | Wer steht dafür ein, wenn das System sich irrt? Kann sich der Nutzer beschweren? | Ein namentlich benannter Verantwortlicher pro System und ein Beschwerdekanal, der bei einem Menschen ankommt |
Keiner dieser Tests braucht ein Forschungsteam. Die kontrafaktischen Tests etwa folgen derselben Idee, mit der Bertrand und Mullainathan 2004 Diskriminierung bei der Personalauswahl gemessen haben: Sie verschickten identische Lebensläufe mit unterschiedlichen Namen und zählten, wie viele einen Rückruf bekamen. Mit einem Sprachmodell geht das mit Hunderten von Paaren an einem Nachmittag, und die Unterschiede im Ton lassen sich mit einem LLM als Richter bewerten, das an menschlicher Prüfung kalibriert ist.
Wenn zwei Prinzipien kollidieren
Was Ethikkodizes am liebsten umgehen: Prinzipien geraten miteinander in Konflikt. Genau dort hört Ethik auf, eine Liste zu sein, und wird zur Entscheidung.
Fairness gegen Fairness. 2016 hat ProPublica COMPAS untersucht, ein System, das in den USA das Rückfallrisiko bewertet, und festgestellt, dass es sich bei schwarzen Angeklagten häufiger irrte und sie als hochriskant einstufte. Das Unternehmen entgegnete, das System sei für beide Gruppen gleich gut kalibriert: Derselbe Wert bedeutete dieselbe Rückfallwahrscheinlichkeit. Beides stimmte zugleich. Im selben Jahr haben Kleinberg, Mullainathan und Raghavan gezeigt, dass es außer in Ausnahmefällen mathematisch unmöglich ist, beide Fairness-Definitionen gleichzeitig zu erfüllen, wenn die Gruppen unterschiedliche Basisraten haben. Sie müssen entscheiden, welche in Ihrem Fall mehr zählt, und diese Entscheidung kann Ihnen das Modell nicht abnehmen.
Transparenz gegen Datenschutz. Um erklären zu können, warum das System etwas gesagt hat, muss man das ganze Gespräch mit seinem Kontext speichern. Um personenbezogene Daten zu minimieren, wie es die DSGVO verlangt, sollte man so wenig wie möglich speichern. Der übliche Ausweg: alles für kurze Zeit pseudonymisiert aufbewahren und nur die als Vorfall markierten Fälle länger behalten. Das ist ein Kompromiss, und er sollte auch als solcher aufgeschrieben werden.
Menschliche Aufsicht gegen Kosten. Jede Entscheidung eines Systems zu prüfen, frisst einen großen Teil der Einsparung auf, die die Automatisierung gerechtfertigt hat. Eine Stichprobe zu prüfen ist billiger, lässt aber Entscheidungen ungeprüft. Die nützliche Frage lautet: Welche Entscheidungen dürfen nicht ungeprüft bleiben (einen Bewerber aussortieren, eine Leistung verweigern) und welche schon (ein Ticket einordnen)?
In allen drei Fällen kann man von einem Unternehmen dasselbe verlangen: ausdrücklich entscheiden, die Begründung aufschreiben und den Namen dessen festhalten, der entschieden hat. Genau das hat Mittelstadt vermisst: eine Methode, um vom Prinzip zum Einzelfall zu kommen, und sei sie noch so bescheiden.
Welcher Teil verpflichtend ist
Die KI-Verordnung hat einen Teil dieser sieben Anforderungen zu Gesetz gemacht, mit unterschiedlichen Stichtagen:
- Seit August 2026 muss jeder Chatbot offenlegen, dass er eine KI ist, und synthetische Inhalte müssen gekennzeichnet sein (Artikel 50).
- Ab Dezember 2027, nach der Verschiebung durch den Digital-Omnibus, brauchen Hochrisiko-KI-Systeme (Personalauswahl, Kredit, Versicherungen, Bildung, wesentliche Dienste) Risikomanagement, hochwertige Daten, Protokollierung, menschliche Aufsicht und in einigen Fällen eine Grundrechte-Folgenabschätzung.
Ausführlicher erklären wir das in unserem Leitfaden zur KI-Verordnung. Die übrigen Anforderungen, etwa das Wohlergehen der Nutzer oder was zu tun ist, wenn Fairness mit sich selbst kollidiert, liegen für die meisten Systeme außerhalb des Gesetzes und hängen davon ab, was jedes Unternehmen entscheidet.
Wo ein KMU anfangen sollte
- Machen Sie eine Bestandsaufnahme. Erfassen Sie jedes KI-System, das im Unternehmen genutzt wird, einschließlich der KI-Funktionen in CRM, Bewerbermanagement oder Helpdesk. Meist sind es mehr, als die Geschäftsführung denkt.
- Wählen Sie ein System, das Menschen betrifft, und schreiben Sie drei Fragen aus der Tabelle oben auf, die darauf zutreffen.
- Machen Sie aus jeder Frage einen Test mit einem Schwellenwert. Zum Beispiel: “Bei 200 Gesprächspaaren, die sich nur im Namen unterscheiden, liegt der Unterschied im Anteil der Antworten, die eine Lösung anbieten, bei höchstens zwei Prozentpunkten.”
- Führen Sie ihn aus, speichern Sie das Ergebnis und wiederholen Sie ihn bei jedem Wechsel von Modell oder Prompt. Das Verhalten eines LLM ändert sich mit jeder Version, und ein Test, der im März bestanden wurde, sagt nichts über die Version vom Juni.
- Dokumentieren Sie die Konflikte, die auftauchen, und wer was entschieden hat.
Wenn Sie das lieber uns überlassen: Wir führen Audits für verantwortungsvolle KI durch, mit Bestandsaufnahme, Testreihen für die Systeme, auf die es ankommt, und einem Bericht mit Maßnahmenplan, mit dem Ihr technisches Team und Ihre Rechtsberatung arbeiten können.