Seit die Transparenzpflichten der EU-KI-Verordnung anwendbar sind, lautet die praktische Frage der Unternehmen sehr konkret: Muss ich „KI-generiert” auf meine Produktbilder schreiben?
Die kurze Antwort: Es hängt davon ab, was erzeugt wurde – und die meisten Artikel zum Thema helfen nicht weiter, weil sie bei der allgemeinen Zusammenfassung der Norm stehen bleiben, ohne zum Anwendungsfall hinabzusteigen. Dieser versucht das Gegenteil.
Ein Hinweis vorab: Dies ist ein Praxisleitfaden aus der Erfahrung der Umsetzung in Projekten, keine Rechtsberatung. Bei Entscheidungen mit regulatorischer Wirkung sollte die Auslegung von Ihrem Rechtsteam bestätigt werden.
Was die Norm verlangt, in Kürze
Der Transparenzteil der Verordnung ruht auf vier Gedanken:
- Interagiert eine KI mit Menschen, müssen diese es wissen – außer es ist aus dem Kontext offensichtlich.
- Wer ein generatives System bereitstellt, muss dessen Ausgaben markieren, in einem maschinenlesbaren Format, das die Erkennung als künstlich erzeugt erlaubt.
- Wer das System einsetzt, muss informieren, wenn erzeugte oder manipulierte Inhalte irreführen können – vor allem, wenn sie reale Personen, Orte oder Ereignisse darstellen.
- Es gibt Ausnahmen für unterstützende oder standardmäßige Bearbeitung, die den Originalinhalt nicht wesentlich verändert.
Punkt 4 wird fast nie erwähnt und verändert im E-Commerce die Schlussfolgerungen am stärksten.
Der wichtigste Fall: Produktbilder
Auf Katalogfotografie angewandt ergeben sich drei recht unterschiedliche Situationen:
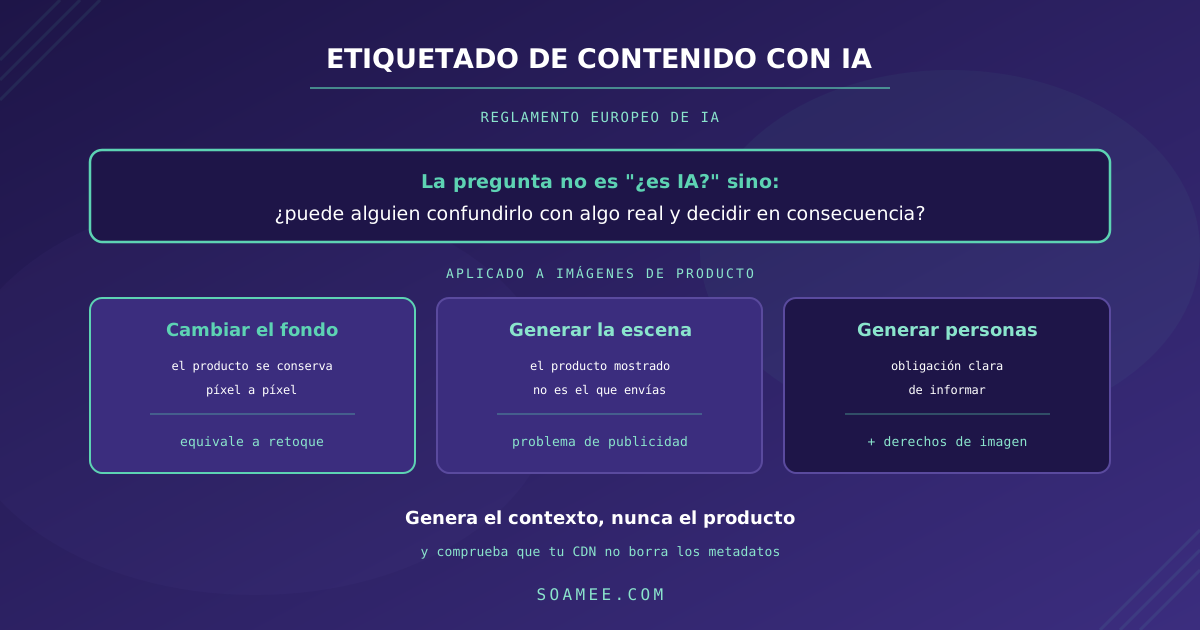
Hintergrund ersetzen oder ein echtes Foto neu ausleuchten. Das Produkt bleibt pixelgenau erhalten, verändert wird die Umgebung. Funktional entspricht das einer Studioretusche – seit Jahrzehnten übliche und akzeptierte Praxis. Dieser Fall passt am besten in die Ausnahme für Bearbeitung, die den Inhalt nicht wesentlich verändert.
Die gesamte Szene inklusive Produkt erzeugen. Hier ist das gezeigte Produkt nicht exakt das versendete. Neben dem Transparenzproblem gibt es ein vorgelagertes Werbeproblem: Sie zeigen etwas, das Sie nicht liefern können.
Modelle oder Personen erzeugen. Das heikelste Terrain. Stellt das Bild eine real wirkende Person dar, fällt es klar unter die Informationspflichten – und überschneidet sich zusätzlich mit Persönlichkeitsrechten.
Die operative Schlussfolgerung, die wir in Projekten geben, ist dieselbe, die wir schon aus geschäftlichen Gründen empfohlen haben: Erzeugen Sie nicht das Produkt, erzeugen Sie seinen Kontext. Diese Praxis hält sowohl regulatorischer Prüfung als auch der Retourenquote am besten stand. Wie sie umgesetzt wird, steht in unserem Leitfaden zur KI-Produktfotografie.
Chatbots und Kundenservice-Agenten
Das ist die am leichtesten zu erfüllende Pflicht und eine der am häufigsten verfehlten – fast immer aus Nachlässigkeit im Design.
Schreibt ein Kunde Ihrem Widget und antwortet ein automatischer Agent, muss erkennbar sein, dass es keine Person ist. Nichts davon verlangt einen einschüchternden Rechtshinweis: Es genügt, dass Name und Auftritt keinen Menschen simulieren und dass das System es auf Nachfrage klarstellt.
Die drei Fehler, die wir sehen:
- Dem Bot einen Personennamen und ein Personen-Profilbild geben.
- Nie darauf hinweisen, dass er automatisiert ist, im Vertrauen darauf, dass „man es merkt”.
- Dass der Agent, direkt gefragt, es nicht klar bestätigt.
Der dritte ist der gravierendste und der am einfachsten zu behebende: Er gehört ab Tag eins in die Systemanweisungen. Wir behandeln das beim Bau von Agenten in wie man einen KI-Agenten mit LLM für den Kundenservice erstellt.
Marketing, Social Media und redaktionelle Inhalte
Illustrative und konzeptionelle Bilder. Eine klar stilisierte Illustration täuscht niemanden über ihre Natur. Das Risiko entsteht, wenn das Bild fotorealistisch ist und eine Szene zeigt, die der Betrachter für real halten kann.
Texte. Werden Inhalte veröffentlicht, um die Öffentlichkeit über Angelegenheiten von allgemeinem Interesse zu informieren, greifen Informationspflichten – mit relevanten Nuancen, wenn eine menschliche Prüfung stattfindet und jemand die redaktionelle Verantwortung übernimmt. Ein von einer Person geprüfter und gezeichneter Unternehmensblog-Artikel steht ganz anders da als ein automatisch und unbeaufsichtigt veröffentlichter Feed.
Stimme und Video mit Personen. Der restriktivste Fall. Wird eine reale Person dargestellt, wie sie etwas sagt oder tut, ist die Informationspflicht eindeutig – dazu kommen Bild- und Stimmrechte, die die Verordnung nicht ersetzt.
Plattformen. Unabhängig von der europäischen Norm haben die großen sozialen Netzwerke eigene Richtlinien zur Offenlegung synthetischer Inhalte, mit automatischer Kennzeichnung anhand von Metadaten. Das Gesetz einzuhalten befreit nicht davon, die Richtlinien der Plattform einzuhalten, auf der Sie veröffentlichen.
Wie in der Praxis gekennzeichnet wird
Es gibt drei Ebenen, die einander ergänzen:
1. Maschinenlesbare Markierung. Metadaten und eingebettete Marker, mit denen automatische Systeme synthetischen Ursprung erkennen. Diese Ebene liegt vor allem beim Modellanbieter – Ihre Pipeline darf sie allerdings nicht zerstören.
Hier liegt der häufigste und leiseste technische Fehler: Bildoptimierungsprozesse entfernen üblicherweise die Metadaten. Wenn Ihr CDN oder Ihr Kompressor EXIF löscht, um Bytes zu sparen, löschen Sie genau das Signal, das die Herkunft belegt. Das lohnt sich zu prüfen, denn niemand bemerkt es, bis jemand fragt.
2. Herkunft und Nachvollziehbarkeit. Standards für Content Credentials, die überprüfbar festhalten, wie eine Datei erstellt und bearbeitet wurde. In diese Richtung bewegt sich die Branche, und eine frühe Einführung ist einfacher als späteres Nachrüsten.
3. Sichtbare Offenlegung. Der Hinweis, den der Nutzer sieht. Diese Ebene liegt bei dem, der veröffentlicht, und verlangt Urteilsvermögen: klar und zugänglich, ohne jede Produktseite in einen Rechtshinweis zu verwandeln.
Wer wofür einsteht
Eine häufige Verwechslung ist die Annahme, bei Nutzung eines Drittanbieter-Werkzeugs liege die Compliance bei diesem. So funktioniert es nicht:
- Der Anbieter des generativen Systems hat Pflichten zur technischen Markierung der Ausgaben.
- Das einsetzende Unternehmen hat eigene Informationspflichten gegenüber seinen Endnutzern.
Dass Ihr Anbieter Bilder korrekt markiert, befreit Sie nicht von der Offenlegung, wenn Sie Inhalte veröffentlichen, die irreführen können. Und umgekehrt: Ein sichtbarer Hinweis heilt nicht, dass Ihre Pipeline die Metadaten zerstört hat.
Praktische Checkliste
Für ein Unternehmen, das generative KI auf Website oder im Produkt einsetzt:
- Inventar. Wo generative KI genutzt wird: Katalog, Marketing, Support, Content.
- Einstufung nach Verwechslungsrisiko. Könnte jemand das für real halten und entsprechend entscheiden?
- Chatbots weisen sich aus, in der Vorstellung und auf direkte Nachfrage.
- Metadaten überleben die Bild-Pipeline: CDN, Kompressoren und Skalierungen prüfen.
- Das Produkt wird nie verändert in Katalogbildern: weder Form noch echte Farbe noch Verpackungskennzeichnung.
- Sichtbare Offenlegung, wo Inhalte mit echtem Material verwechselt werden könnten.
- Interne Aufzeichnung, welche Inhalte erzeugt wurden, mit welchem Werkzeug und wer sie freigegeben hat.
- Rechtliche Prüfung der Grenzfälle, besonders wenn Personen auftreten.
Der vorletzte Punkt wird immer unterschätzt und rettet die Lage, wenn eine Anfrage kommt: Ohne Aufzeichnung erinnert sich sechs Monate später niemand, ob ein bestimmtes Bild erzeugt oder fotografiert wurde.
Was schon vor der Verordnung galt
Man sollte nicht aus dem Blick verlieren, dass irreführende Werbung längst verboten war, bevor es generative Modelle gab. Ein Produkt so zu zeigen, wie es nicht geliefert wird, ist ein verbraucherrechtliches Problem – unabhängig davon, wie das Bild entstand: mit KI, mit Photoshop oder durch einen sehr geschickten Fotografen.
Für den E-Commerce ist das zugleich beruhigend und anspruchsvoll. Beruhigend, weil sich das zugrunde liegende Kriterium nicht geändert hat. Anspruchsvoll, weil „das war die KI” nie eine Verteidigung war.
Fazit
Die richtige Frage lautet nicht „Muss ich meine KI-Bilder kennzeichnen?”, sondern „Kann jemand das für etwas Reales halten und auf Grundlage dieser Verwechslung entscheiden?”. Nahezu alle Praxisfälle lösen sich mit diesem Kriterium, und es deckt sich mit dem, was das Verbraucherrecht ohnehin verlangte.
Für einen Onlineshop ist die operative Regel einfach und deckt sich mit dem, was geschäftlich ohnehin ratsam ist: Erzeugen Sie den Kontext, nie das Produkt; weisen Sie Ihre automatischen Agenten aus; zerstören Sie keine Metadaten; und dokumentieren Sie, was Sie erzeugen.
Den Gesamtüberblick über die Verordnung und ihre Fristen gibt KI-Regulierung in Europa. Wenn wir Ihren konkreten Fall prüfen sollen – welche Inhalte Sie erzeugen und wo Sie exponiert sind –, schildern Sie uns Ihre Situation.